The Network Layer
考纲 5.1 网络层设计要点(虚电路子网、数据报子网) 5.2 路由算法(最优化原则、sink tree、最短路径路由、距离矢量路由及无穷计算问题、链路状态路由、距离矢量路由和链路状态路由的比较、分级路由、广播路由、移动路由) 5.3 拥塞控制(RED) 5.4 服务质量(资源预留、缓冲、抖动、漏桶算法、令牌桶) 5.5 网络互连(隧道技术) 5.6 Internet的网络层(IPv4协议、IP地址、子网、子网掩码、子网划分、CIDR、地址聚合技术、NAT、ICMP、ARP工作过程、DHCP、OSPF、BGP)
数据链路层 vs. 网络层
数据链路层:负责把帧从一段链路的一端传送到另一端。(一跳的传输)
网络层:负责把分组从源主机一路传送到目的主机。(端到端的传输)
- 网络层必须知道网络拓扑结构(所有路由器和链路的集合),并从中取出适当的路径
- 网络层必须仔细选择路由器,避免某些通信线路和路由器负载过重,而其他线路和路由器空闲
- 当源端和接收方处于不同的网络时,出现的新的问题也需要网络层来解决
5.1 网络层的设计问题
5.1.1 存储转发数据包交换
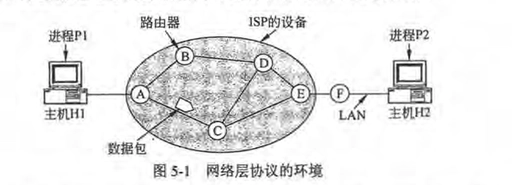 路由器处理数据过程:当一个数据(帧)到达路由器的一个入境端口后,首先进行帧的校验和验证(数据链路层功能),通过校验的帧中的负载字段(数据包或分组)提交给网络层,进入网络层的存储队列(网络层存储功能),路由器根据一定的调度规则处理队列中的数据包(网络层调度功能),被调度到的数据包根据路由表确定出境端口(网络层路由功能),并将数据包转发到所确定的端口(网络层转发功能),出境端口按照端口类型封装数据包为帧并发送出去(数据链路层功能)
存储转发:将入境数据缓存(存储),根据一定的规则调度到出境端口并发送(转发)的过程
5.1.2 提供给传输层的服务
设计网络层的目标
- 向上提供的服务应该独立于路由器技术
- 应该向传输层屏蔽路由器的数量、类型和拓扑关系
- 传输层可用的网络地址应该有一个统一编址的方案(?? 现在IP地址会发生改变)
网络层向传输层提供的服务包括无连接的服务和面向连接的服务
- Connection-less services 无连接服务
- 以Internet社团为代表
- 主机自己完成错误控制和流量控制
- Connection-oriented services 面向连接服务
- 以电话公司为代表
- 服务质量是最主要的因素
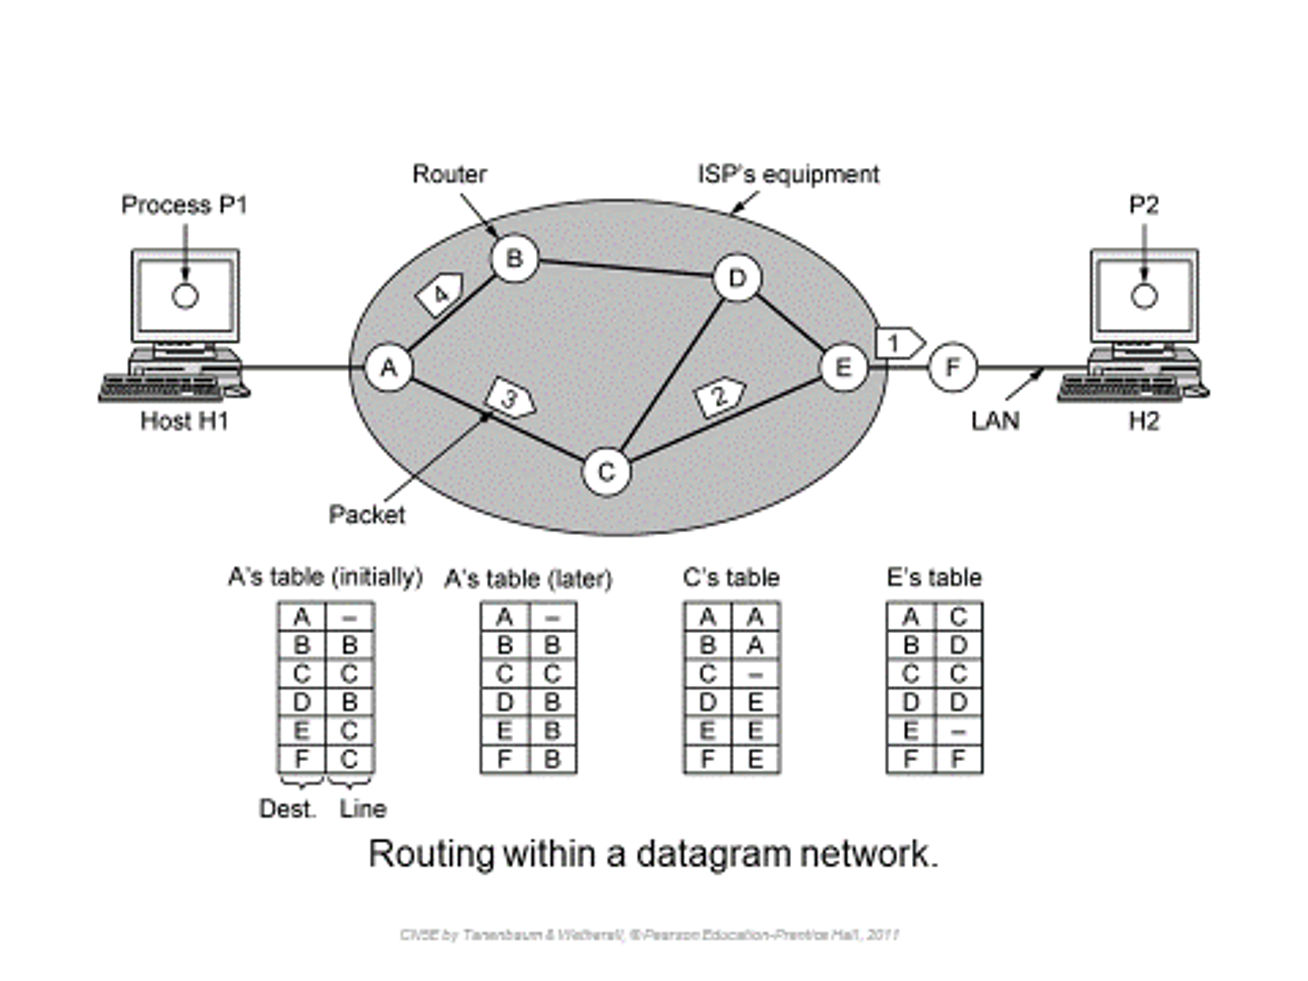
无连接服务的实现
无连接服务:所有的数据包都被独立地注入网络中,并且每个数据包独立路由,不需要提前建立任何设置
- 数据包:称为数据报Datagram
- 数据报网络Datagram network
所有的数据包被独立地注入到网络中,每个数据包携带完整的目的地址,在网络中被独立路由(在每个路过的路由器根据本身的路由表,和数据包中的目的地址,确定下一步的转发线路)。数据包之间由于网络状态的变化(反映到某些路由器路由表的变化,从而导致从当前路由器以后路径的变化)可能经过不同的路径。所谓“独立”,指的是任意两个数据包的路径没有相关性
面向连接服务的实现
面向连接服务:在发送数据包之前,必须首先建立起一条从源路由器到目标路由器的路径
- 这个连接称为虚电路virtual circuit
- 对应的网络 虚电路网络virtual-circuit network
当建立一个连接时,从源机器到目标机器之间的一条路径就被当作这个连接的一部分确定了下来,并且保存在这些中间路由器的表中。所有需要在这个连接上通过的流量,都使用这条路径,当连接被释放时,虚电路也随之消失
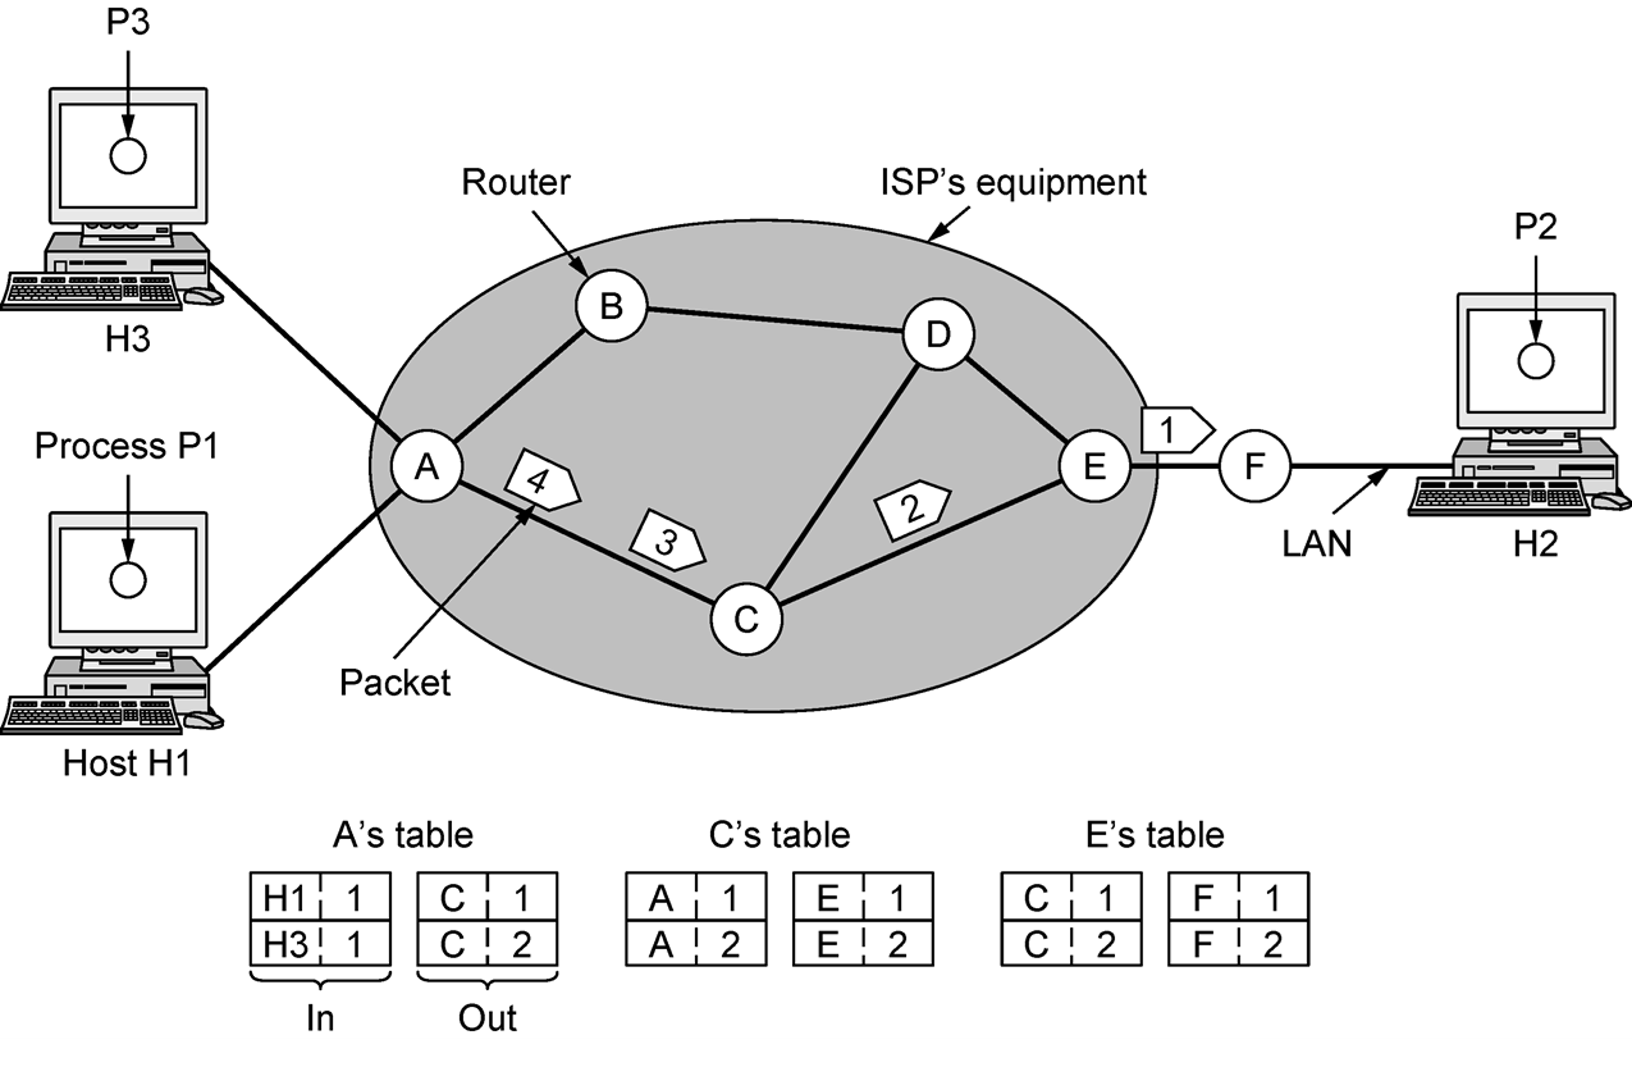 可以分为按需虚电路和永久虚电路。按需虚电路为每次传输计算一条路径,传输完毕后拆除虚电路;永久虚电路一直保存在网络中,每次传输选择一条虚电路。
虚电路使用一个标识符标识本虚电路。虚电路标识符具有“局部(本地)”特征,即每台路由器可能选择不同的标识符。标识符在整条路径上不断变化,不影响数据转发。
每个数据包携带一个虚电路标识符用于中间路由器的转发,每经过一个路由器,虚电路标识符的取值可能变化(标签交换)
5.1.5 虚电路与数据报网络的比较
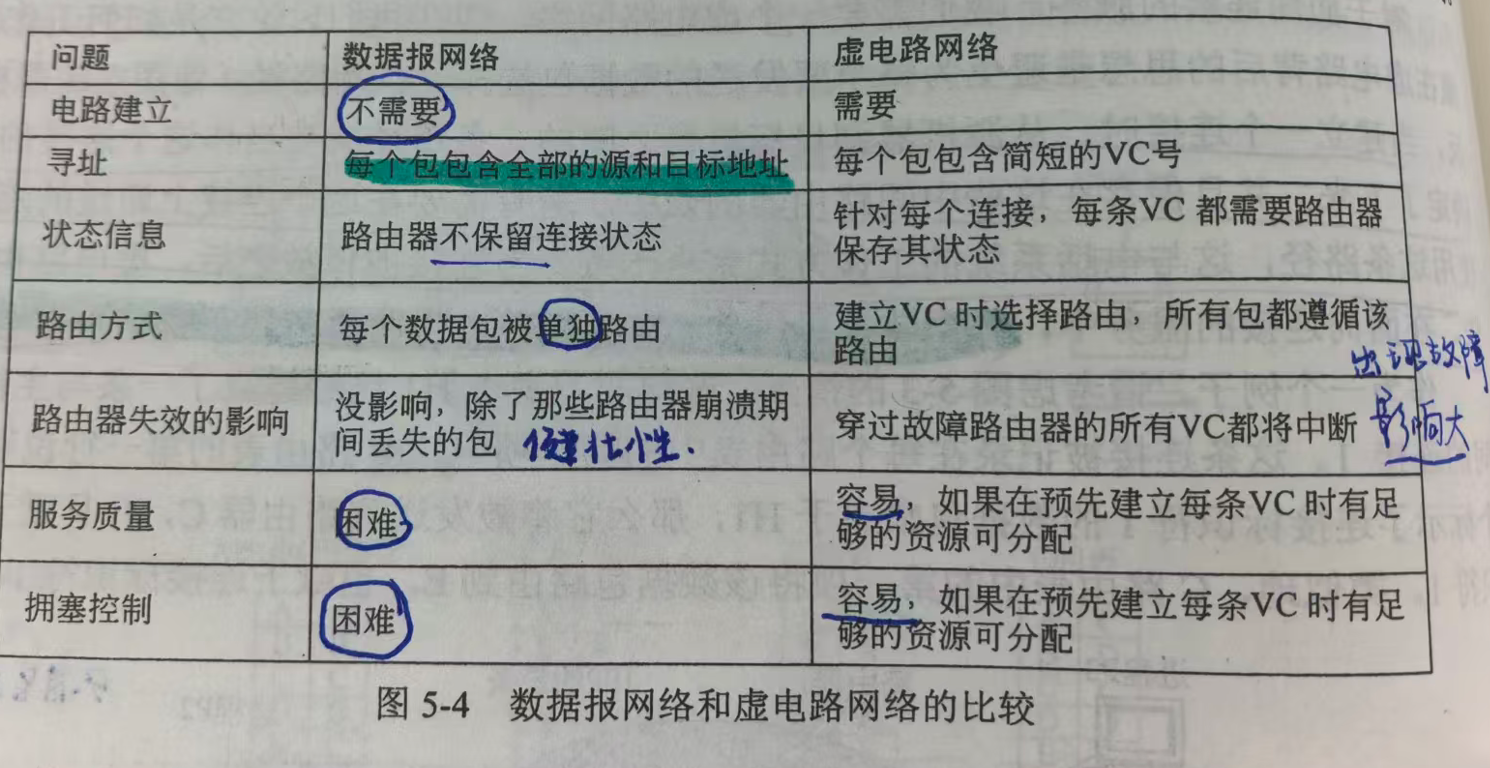
虚电路和数据报之间存在一些权衡。
对于数据报子网来说,需要较大的路由表空间
二者的权衡之一是:虚电路需要连接建立时间,而数据报需要逐个分组解析地址的时间。
对于虚电路子网来说,比较容易实现 QoS 和拥塞控制。
但是虚电路子网也存在脆弱性问题
5.2 路由算法
路由Routing vs 转发进程Forwarding processes
- 路由:对使用哪一条路径做出决策
- 负责生成和更新路由表
- 转发:当一个数据包到达时应该采取什么动作
- 在每个数据包到达的时候对它进行处理,它在路由表中查找该数据包所对应的出境线路
路由算法是网络层软件的一部分
- 功能
- 负责管理路由表并作出路由选择
- 负责确定一个 入境数据应该被发送到哪一条输出线路上
- 数据报网络:路由器必须针对每一个到达的数据包重新选择路径,因为自上一次选择了路径之后,最佳路径可能已经发生了改变
- 虚电路网络:只有当建立一条新的虚电路时,才需要做路由决策,此后数据包只要沿着已经建立的路径向前传递即可➡️会话路由(session routing)
- 特性:正确性、简单性、鲁棒性、稳定性、公平性、最优性
- 分类
- 非自适应算法 Nonadaptive algorithm
- 不会根据当前测量或者估计的流量和拓扑结构来调整它们的路由决策。相反所使用的路由选择是预先在离线情况下计算好,并在网络启动时被下载到路由器中的➡️静态路由➡️无法响应故障,对于路由选择已经很清晰的场合有用
- 自适应算法Adaptive algorithm
- 改变它们的路由决策以便反映出拓扑结构的变化,通常也会反映出流量的变化情况➡️动态路由
- 非自适应算法 Nonadaptive algorithm
最优化原则
最优路径的一般陈述(最优化原则):如果路由器J在从路由器I到K的最佳路由上,那么从J到K的最优路径也必须遵循同样的路由
汇集树(sink tree)
- 从所有的源到一个指定目标的最优路径的集合构成了一棵以目标节点为根的树 路由算法的目标是为所有的路由器找到这样的汇集树,并根据汇集树来转发数据包
- 汇集树不一定唯一,有可能存在具有相同路径长度的其他汇集树
最短路径路由
基本想法:构造一张网络图,图中的每个节点代表一个路由器,每条边代表一条通信线路或者链路,为了选择一堆给定路由器之间的路由,算法只需要在图中找出它们之间的最短路径
- 度量路径长度的方法/依据
- 跳数/物理距离/平均延迟/信道带宽/吞吐量/通信开销/队列平均长度/站点数量等等
- 算法:迪杰斯特拉Dijkstra算法
Flooding算法
泛洪算法
泛洪技术:将收到的每个分组,从除了分组到来的线路外的所有线路上发出 问题:产生大量重复分组 抑制措施:
- 在每个分组的头部设置一个跳计数器,每经过一条计数器减一,当计数器到达0时就丢弃该数据包
- 记录下哪些分组已经被扩散过了 ➡️问题:产生随着跳数增大而指数增长的重复数据包,而且路由器要复制以前已经看过的数据包 改进:
- Selective Flooding (选择性扩散法)
- 仅将分组扩散到与正确方向接近的线路上
- 让路由器跟踪已经泛洪过的数据包,从而避免二次发送它们
- 让每个源路由器在接收来自主机的数据包时填上一个序号,然后每个路由器为每个源路由器准备一张表,记录已经观察过的来自源路由器的序号,如果入境数据在这张表中,他就不能再被泛洪到其他路由器
- 为了防止表无限膨胀,每个表应该使用一个计数器k作为参数,表示直到k的所有序号都已经观察到了
应用:实际应用较少
- 健壮性好➡️军事用途
- 分布式数据库更新
- 无线广播网络
- 在无线网络中,站传送的全部信息都可以被位于其无线范围内的所有其他站接收
💡距离矢量算法
Distance Vector Routing
- 原理:
- 每个路由器维护一张表(即一个矢量),表中列出当前已知的到每个目标的最佳距离(多种度量方式)以及所使用的链路
- 每个路由器维护一张路由表,它以每个路由器为索引,并且每个路由器对应一个表项,该表项包含两个部分:到达该目标路由器的首选出境线路+到达该目标路由器的距离估计值
- 这些表通过与相邻路由器之间相互交换信息来不断更新表的信息
 示例:
- 每个路由器维护一张表(即一个矢量),表中列出当前已知的到每个目标的最佳距离(多种度量方式)以及所使用的链路
- 应用:ARPANET、因特网(对应的路由协议:RIP)
- 缺点:记录信息耗时过多,算法收敛速度慢(由于无穷计算问题)
- 无穷计算问题:距离矢量算法的严重缺陷:虽然总是能够收敛到正确答案,但是速度可能非常慢,尤其是对于好消息的反映非常迅速,对于话消息的反映异常迟缓
- 距离矢量路由算法只是根据邻居的距离矢量计算自己的路由表,当计算一条路径时,无法判断邻居所说的最短路径是否通过自己(这是分布式算法本身固有的缺陷),所以可能带来环路问题
- 环路的补救与避免
- 定义最大值
- 在RIP (Routing Information Protocol)路由协议中,允许跳数最大值为16 ,这个方案只是补救措施,不能避免环路产生
- 水平分割
- 水平分割的思想就是在路由信息传送过程中,不再把路由信息发送给接收此路由信息的接口上
- 路由器将从某个邻居学到的路由信息又告诉了这个邻居
- 定义最大值
- 环路的补救与避免
- 无穷计算问题:距离矢量算法的严重缺陷:虽然总是能够收敛到正确答案,但是速度可能非常慢,尤其是对于好消息的反映非常迅速,对于话消息的反映异常迟缓
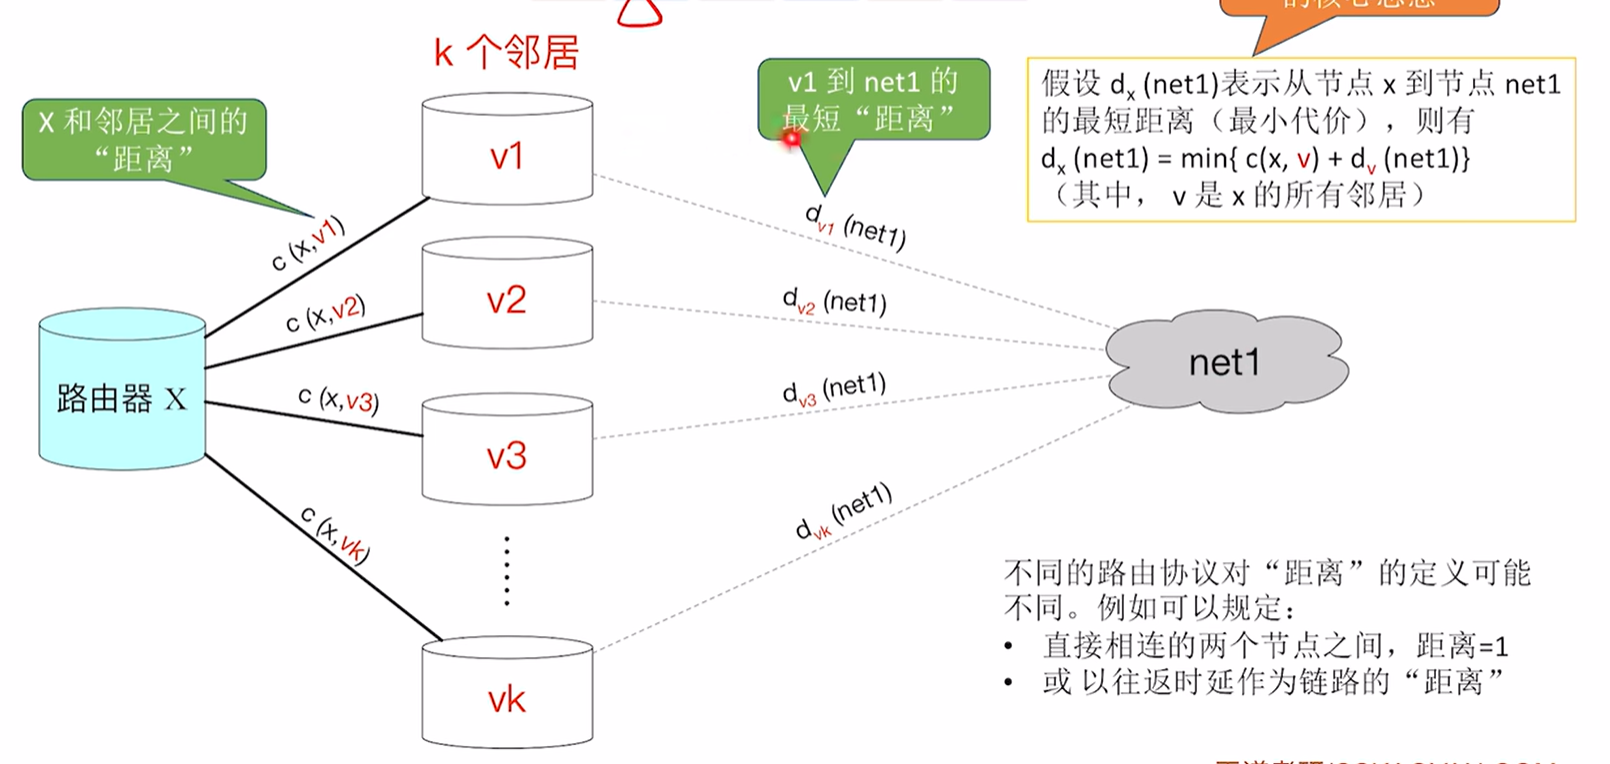 示例:
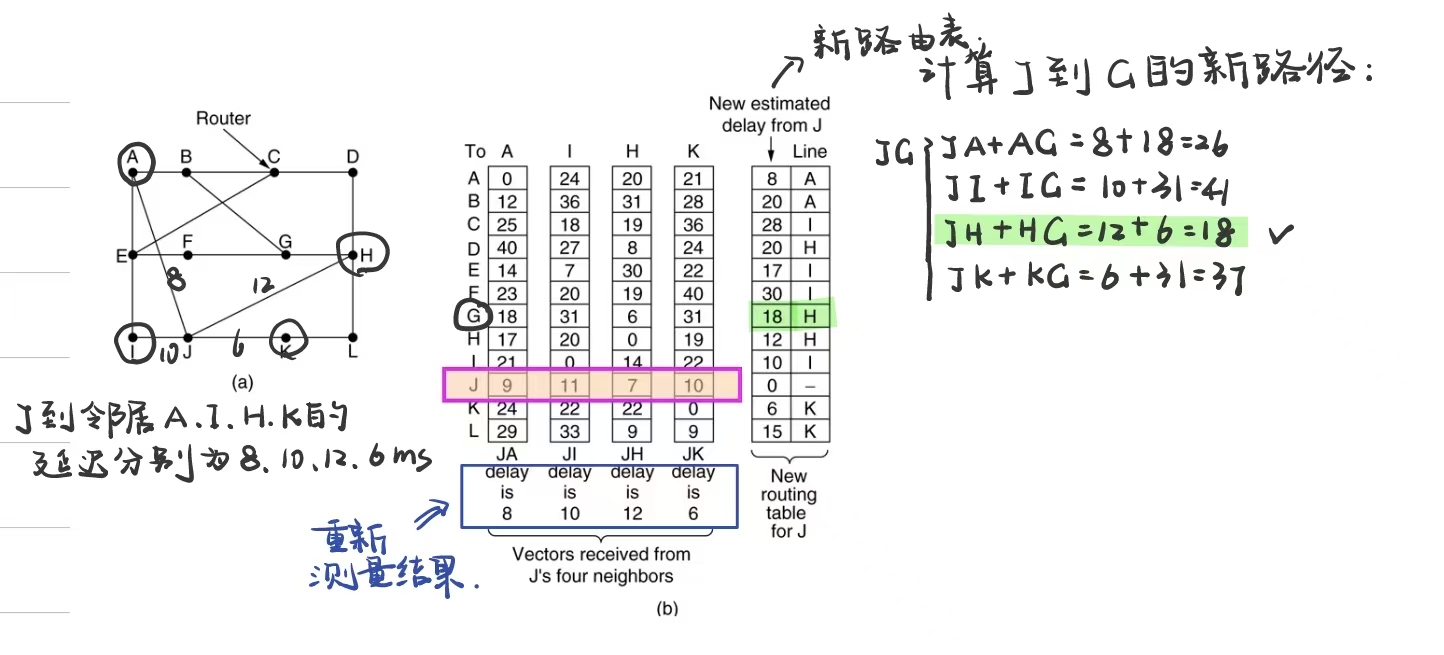
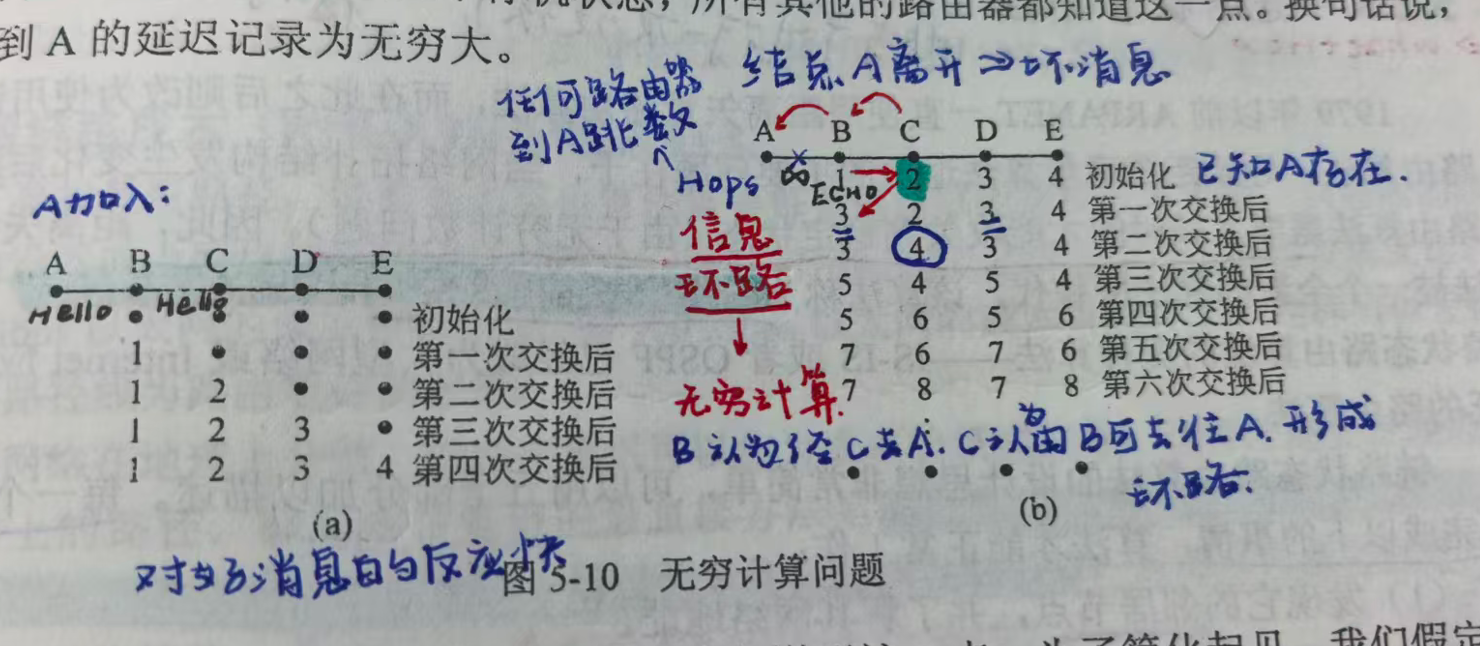
启发式工作的问题核心:当X告诉Y它有一条通往某个地方的路径,Y无从直到自己是否已经在这条路径上
💡链路状态路由
Link State Routing
算法步骤(会复述):(每个路由器必须完成以下事情,算法才能正常工作)
- 发现它的邻居节点并了解其网络地址
- 设置到每个邻居节点的距离或成本度量值
- 构造一个包含所有刚刚获知的链路信息分组
- 将这个分组发送给所有其他的路由器,并接收来自所有其他路由器的信息分组
- 计算出到每个其他路由器的最短路径 算法将完整的拓扑结构分发给了每一个路由器,然后每个路由器运行dijkstra算法就可以找到从本地到每一个其他路由器的最短路径
Step1:发现邻居 当一个路由器启动时,它的第一个任务是找出哪些路由器是它的邻居
- 只需要在每一条点到点的线路上发送一个特殊的HELLO 分组来实现,线路的另一端路由器应该返回一个应答来说明自己是谁
Step2:设置链路成本/测量线路开销或延迟
- 成本:自动设置/网络运营商配置
- 使成本与链路带宽成反比
- 链路的延迟作为成本的组成部分
- 通过线路给另一边发送一个特殊的ECHO分组,要求对方立即发挥,通过测量往返时间再除以2,发送的路由器可以得到一个合理的延迟估算值(测多次取平均)
Step3:构造链路状态分组 一旦收集到了所需要的交换信息,每个路由器的下一步工作是构建一个包含所有这些信息的数据分组
- 发送方的标识符(IP地址)
- 一个序号(Seq)
- 年龄(Age)
- 邻居列表,对于每个邻居,同时给出到这个邻居的延迟
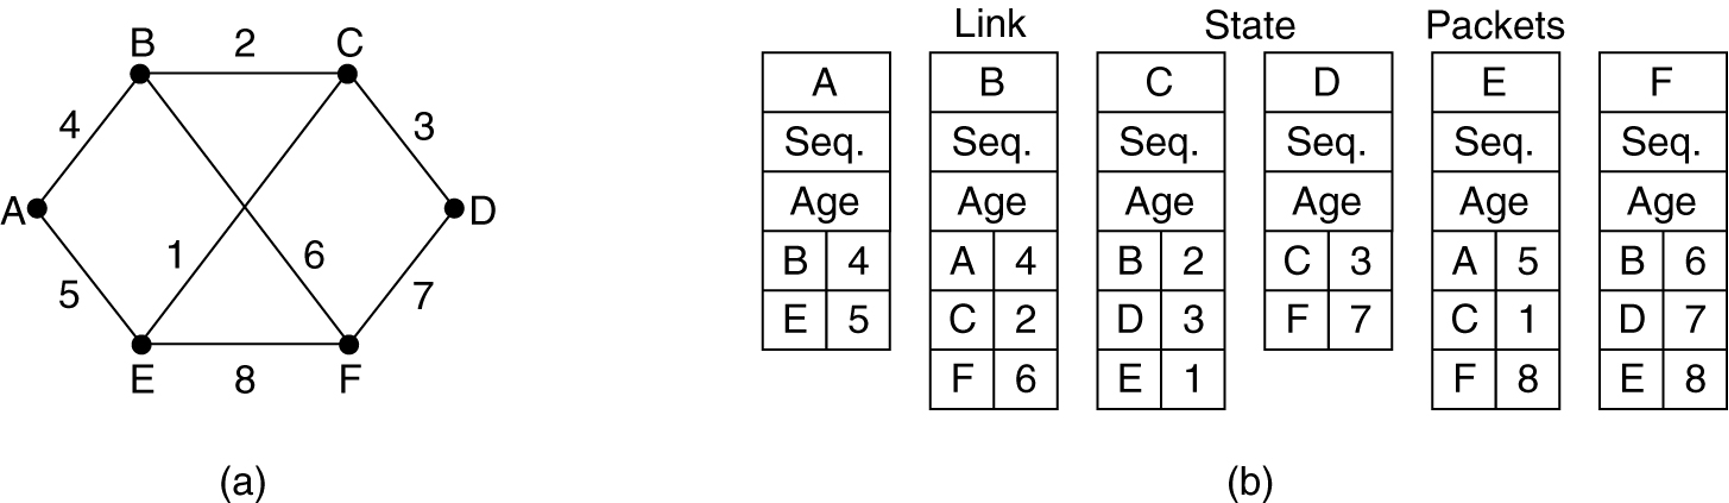
困难的是什么时候构造数据分组
- 周期性地创建数据分组:以一定的时间间隔创建链路状态数据分组
- 每当发生某些重要的事情时才创建数据分组
- eg:一条线路断掉/一个邻居节点停机/邻居节点重新恢复运行
Step4:发布链路状态分组 基本思路:使用泛洪法将链路状态分组发送给所有路由器。为了控制泛洪规模,每个数据分组都有一个序号,序号随着每一个新分组发出而逐一递增。路由器记录下它所看到的所有(源路由器,序号)对。当一个新的链路状态数据分组到达路由器检查这个新来的数据分组是否已经在上述观察到的列表中
- 如果是新数据分组:把它转发到出入境线路之外的所有其他线路上
- 重复数据分组:丢弃
- 如果数据包分组的序号小于当前所看到的来自该源路由器的最大序列号,则被当作过时数据分组而拒绝接收
问题:
- 序号绕回,可能产生混淆➡️使用一个32位的序号
循环使用
- 路由器崩溃,造成顺序号丢失/顺序号传送错误➡️在每个数据分组的序号之后包含一个年龄age字段,并且每秒钟年龄减1,当年龄值被减到0时,来自路由器的该信息被丢弃
改进:
- 路由器将分组先存储,比较后再发送 :当一个链路状态数据分组被泛洪到一个路由器时,它并没有立即被排入队列等待传输,相反首先将其放入一个保留区内等待一段时间。如果在这个数据分组被转发出去之前,来自于同一个源路由器的链路状态数据分组也到来了,那么比较它们的序号
- 序号相等➡️丢弃重复的分组
- 序号不等➡️丢弃老的包
- 为了防止线路产生错误导致丢包和错包,所有的链路状态分组都要被确认
- send flag:该数据包必须在所指示的线路上发送
- ACK flag:它必须在这条线路上得到确认
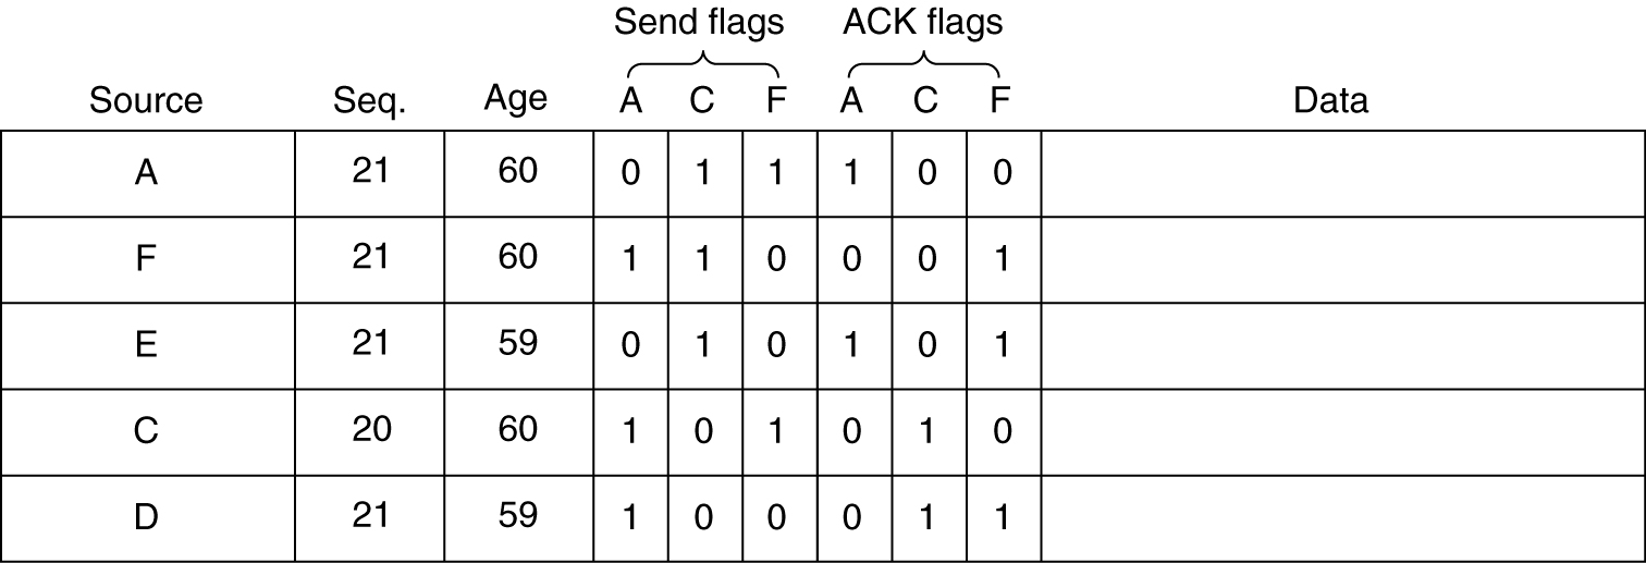
Step5:计算新路由
- 一旦路由器已经积累出来了全部的链路状态数据分组之后,可以构造出完整的网络图,因为每条链路都已经被表示出来了
- 每条链路被表示了两次,每个方向各一次,不同方向的链路可能有不同的成本
- 在本地路由器运行Dijkstra algorithm
应用:
- OSPF协议 (Open Shortest Path First)
- 中间系统至中间系统IS-IS
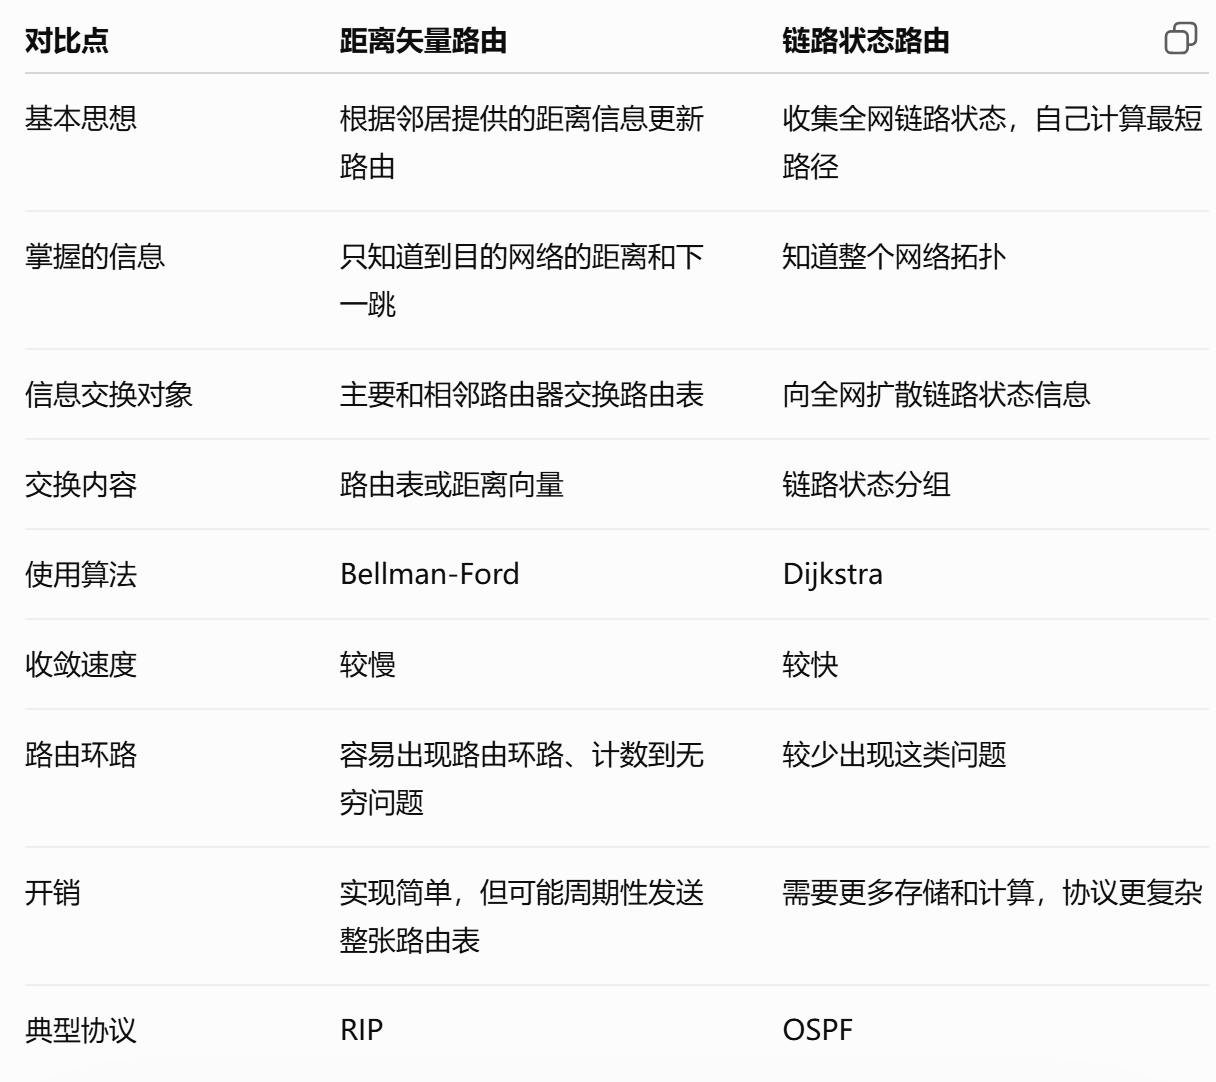
距离矢量路由 vs 链路状态路由
分级路由/层次路由
Hierarchical Routing
产生背景:
- 随着网络规模的增大,路由器的路由表也成比例地增长
- 不断增长的路由表不仅消耗路由器内存,还需要更多的CPU时间来扫描路由表以及更多的带宽来发送有关的状态报告
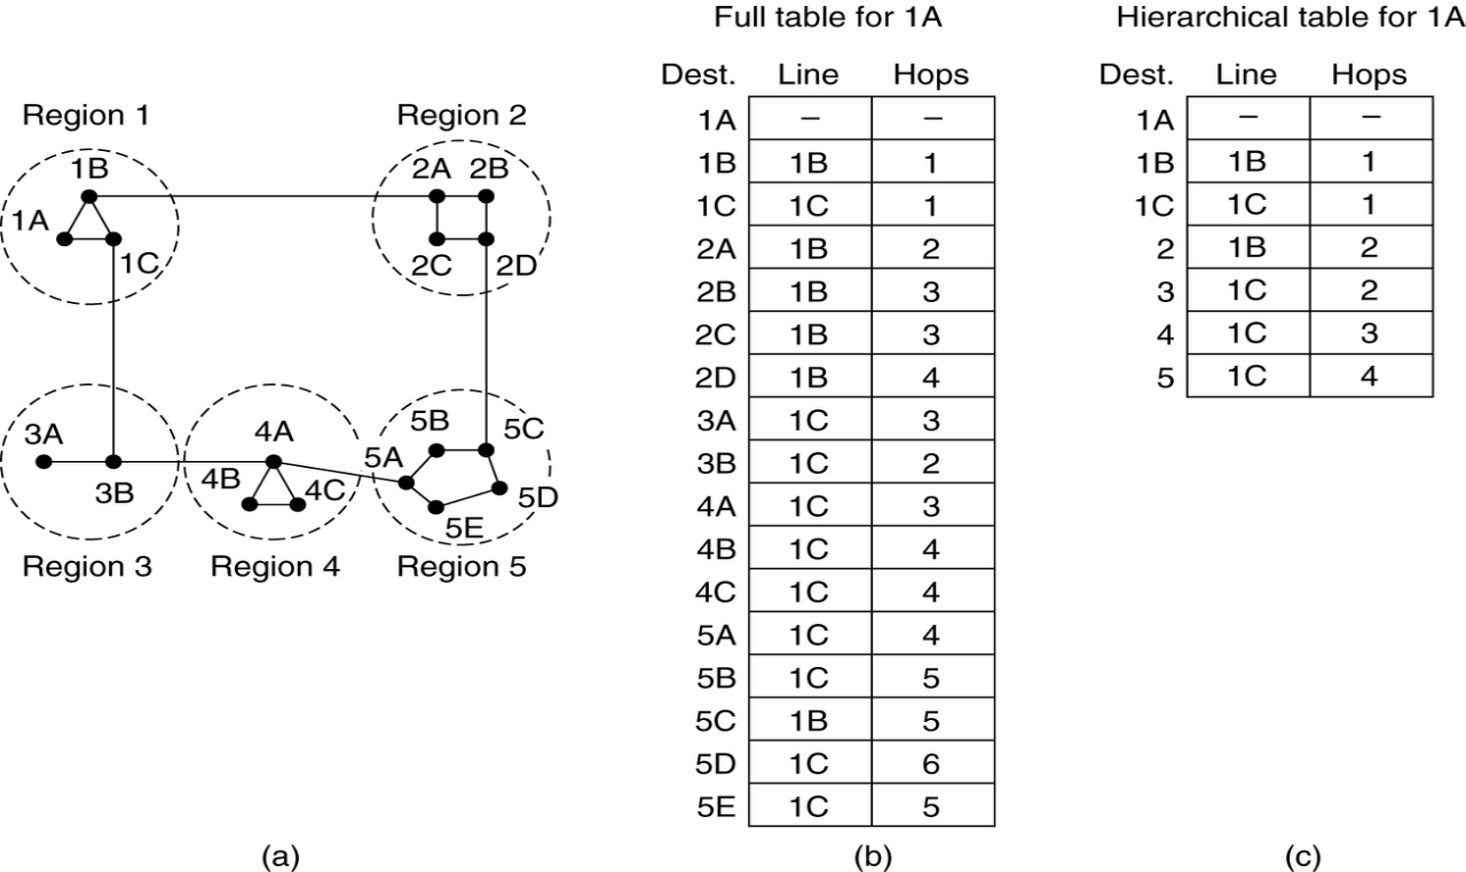
基本思想:路由器被划分成区域,每个路由器知道如何将数据分组路由到自己所在区域的目标地址,但是对于其他区域的内部结构并不知情
- 所有到达本区域的路由器表项和原先一样
- 所有到其他区域的路由都被压缩到单个路由器中
优点:节省了表空间
代价:增加了路径长度
对于一个包含N个路由器的网络,最优的层数lnN,每个路由器所有的路由表项是elnN
 优点:节省了表空间
代价:增加了路径长度
对于一个包含N个路由器的网络,最优的层数lnN,每个路由器所有的路由表项是elnN
广播路由
Broadcast Routing 在有些应用中,需要支持广播、组播、选播、移动节点等。这需要根据基本路由算法进行扩展,从而产生了新的路由算法。 它们基本解决方式是根据最短路径算法计算一棵树(汇集树/生成树),在路由表中添加相应的表项和相应的转发算法,从而支持数据通过计算得到的树进行传递。
广播:给全部目标地址发送一个数据分组 实现广播的几种算法:
- method1:让源机器简单地给每一个目标单独发送一个数据包
- 浪费带宽+要求源机器有所有目标机器完整的地址列表
- method2:泛洪/扩散法 flooding
- method3:多目标路由/多目的地路由选择
- 每个数据分组包含一组目标地址或者一个位图,由该位图指定所期望到达的目标
- 依然要求源端知道全部的目标地址,对于路由器来说确定从哪些线路转发多目标数据分组的工作量太大
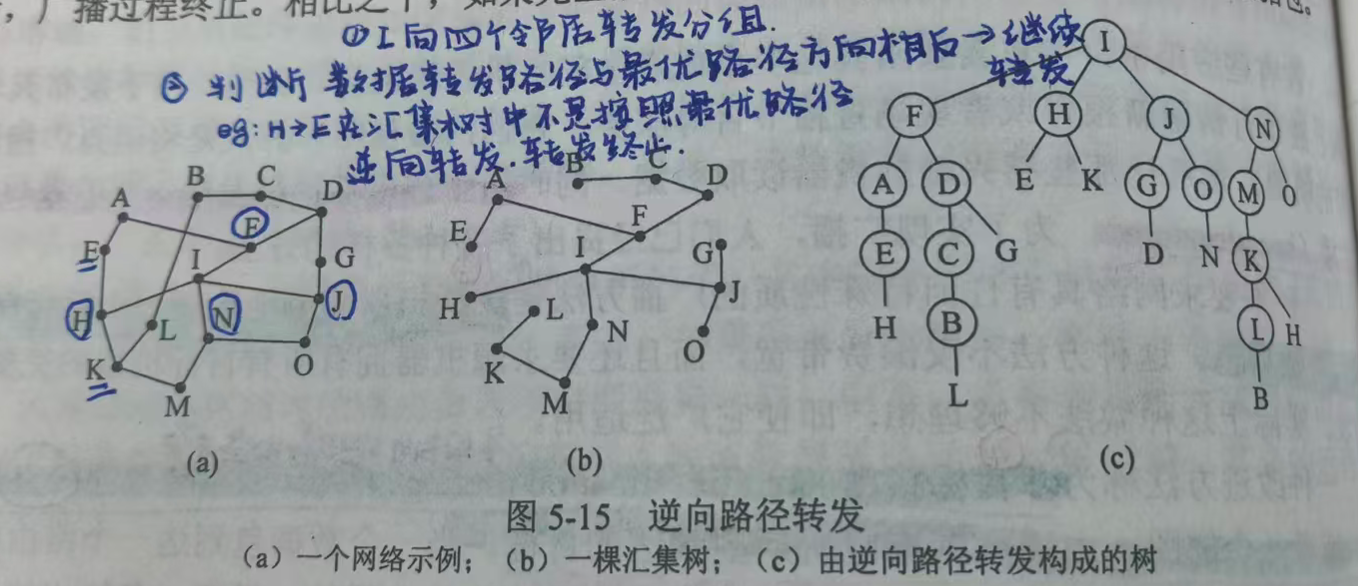
- method4:逆向路径转发RPF(Reverse Path Forwarding)
- 当一个广播数据包到达一个路由器时,路由器检查它到来的那条线路是否正是通常用来给广播源发送数据包用的那条线路(自己到该广播源的最短路径所使用的接口)。如果是,说明这是一个极好的机会,该广播数据分组是沿着最佳路径被转发过来的,因而是到达当前路由器的第一份副本。如果是这种情况,则路由器将该数据分组转发到除了到来的那条线路之外的所有其他线路上。然而,如果广播数据包是从其他任何一条并非首选的到达广播源的线路入境的话,该数据包被当作一个可能的重复数据包而丢弃
- 优点:有效且易于实现
- 当一个广播数据包到达一个路由器时,路由器检查它到来的那条线路是否正是通常用来给广播源发送数据包用的那条线路(自己到该广播源的最短路径所使用的接口)。如果是,说明这是一个极好的机会,该广播数据分组是沿着最佳路径被转发过来的,因而是到达当前路由器的第一份副本。如果是这种情况,则路由器将该数据分组转发到除了到来的那条线路之外的所有其他线路上。然而,如果广播数据包是从其他任何一条并非首选的到达广播源的线路入境的话,该数据包被当作一个可能的重复数据包而丢弃
- method5:利用发起广播的路由器位根的汇集树或利用生成树
- 生成树:包含所有的路由器且无环路
- 问题:每一个路由器必须知道这棵生成树
- 生成树:包含所有的路由器且无环路
组播/多播路由
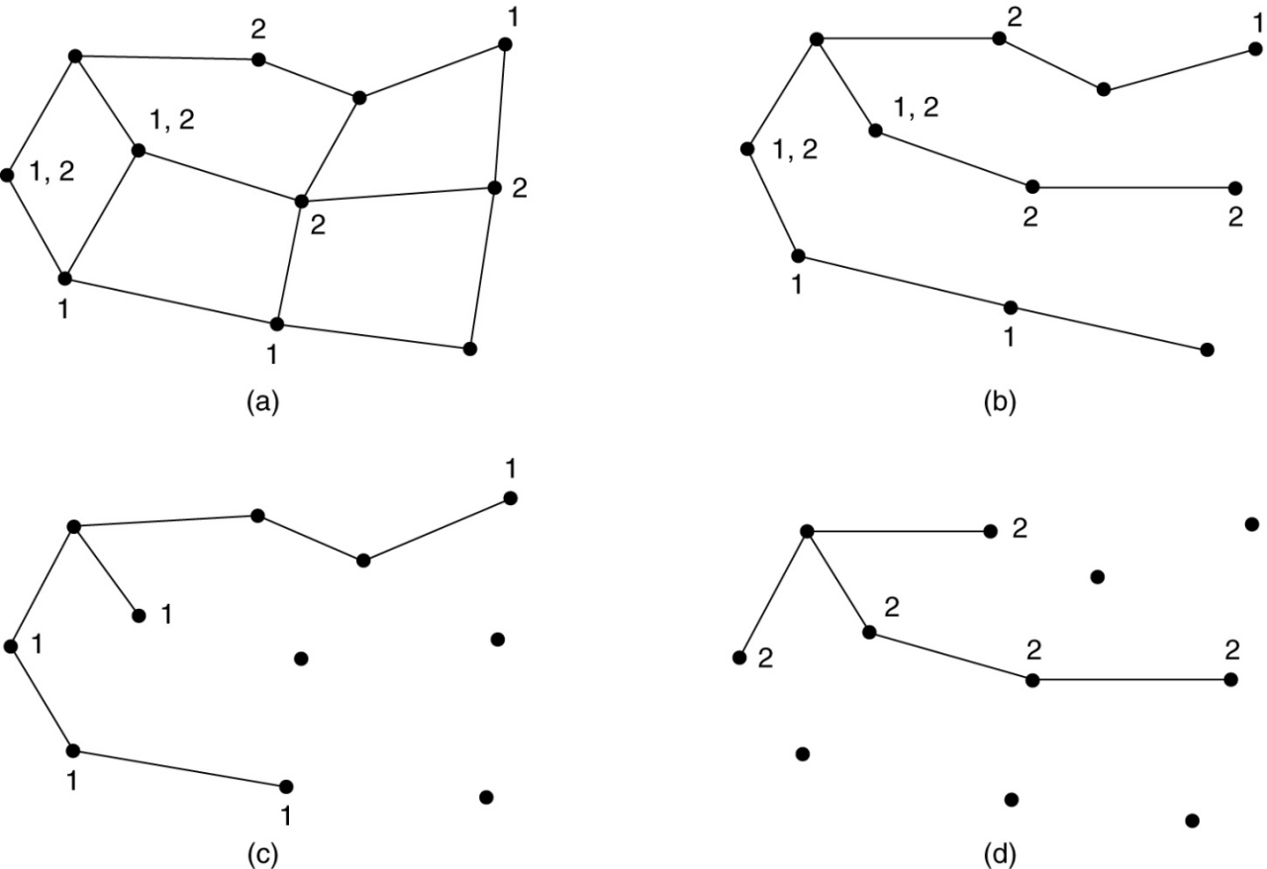
Multicast Routing
解决方案:修剪广播生成树把不通往组成员的链路从树中删除。修建结果得到的是一棵有效的组播生成树
- 不同的组播组有不同的生成树
移动主机路由
Routing for Mobile Hosts
静态用户➡️从不移动的用户 非静态用户(迁移用户、漫游用户) ➡️移动用户 外地代理 – 管理所有来当地的动态用户 本地代理 – 管理本属本区域,但当时正在外地的用户
| 移动主机的数据分组路由过程 | |
|---|---|
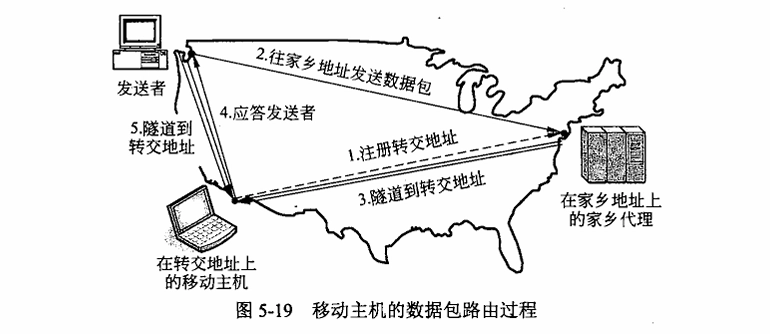 移动主机路由:支持主机的移动:能够找到它并将数据传送给它。 移动支持:家乡代理,每台主机到达其它地方后,需要与家乡(登记注册地)服务器通信,告知自己现在的位置。 |
1. 其它节点向移动主机发送数据时,首先发送到其注册地址(这是主机唯一对外宣称的官方地址),家乡代理将数据转发给移动主机。 2. 移动主机使用当前地址与发送主机联系。 3. 发送主机直接发送到移动主机当前位置。 中间需要隧道技术支持:隧道技术即为封装技术 |
典型的登录过程:
- 外地代理定期广播分组,宣布自己的存在及地址;同时,移动主机可以广播,问“这里有没有外地代理?”
- 移动主机登录到外地代理
- 外地代理与移动主机的本地代理联系
- 本地代理检查安全性信息
- 外地代理得到本地代理的确认后,建立一个表项,并通知移动主机已经登录了
5.3 拥塞控制
拥塞:网络中存在太多的数据分组导致数据分组被延迟和丢失,从而降低了传输性能,这种情况叫拥塞
- 网络层和传输层共同承担处理拥塞的责任 拥塞控制 vs 流量控制
- 拥塞控制:确保网络能承载所有到达的流量
- 全局性问题:包括所有的主机和所有的路由器
- 流量控制:确保一个快速的发送方不会持续地以超过接收方接受能力的速率传输数据
- 只与特定的发送方和特定的接收方之间的点到点流量相关
| 太多的流量导致性能急剧下降 | 分析 |
|---|---|
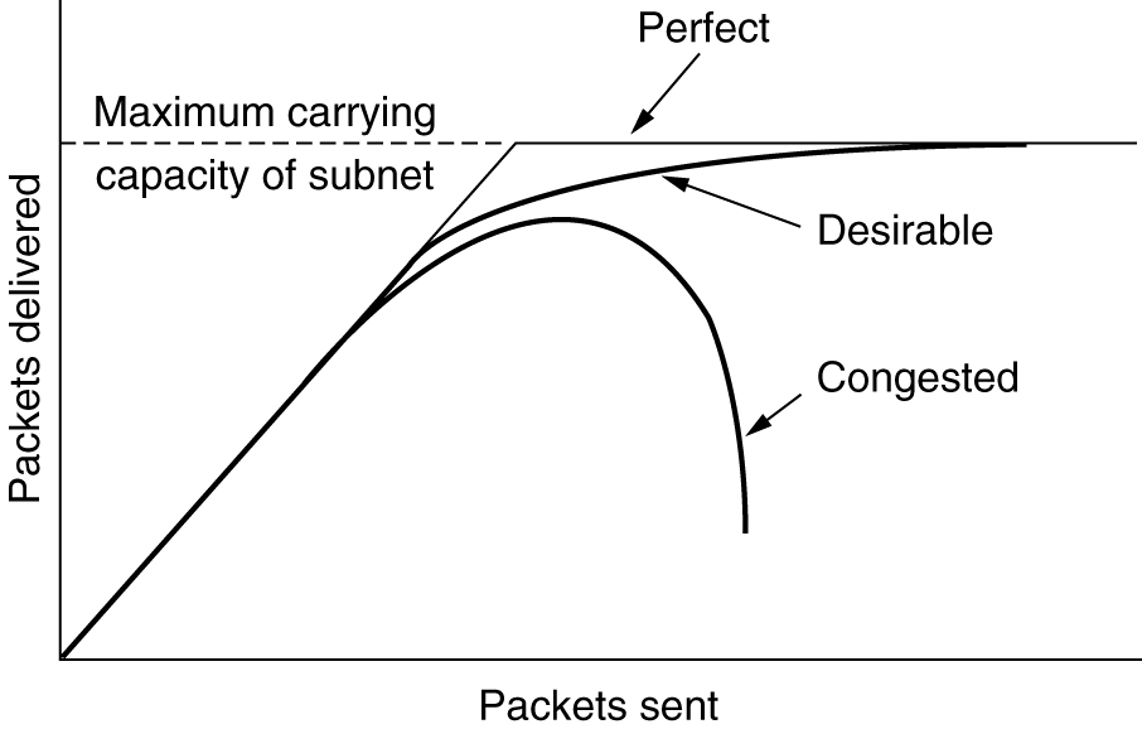 |
当主机发送到网络的数据分组数量在其承载能力范围之内,送达的数据分组数与发送的数据分组数呈现出正比例增长 然而,随着负载接近承载能力,偶尔突发的流量填满了路由器内部的缓冲区,因而某些数据分组会被丢失,这些丢失的数据分组消耗了部分容量(传输的过程中消耗了资源),因此送达的数据分组的数量低于理想曲线,网络开始拥挤 丢失的分组也占用了网络容量,但没有贡献有效吞吐量 |
| 拥塞崩溃Congestion collapse:随着注入的负载增加到超出网络的容量,网络性能骤降 |
拥塞产生的原因
- 传输层注入太多的、超过网络处理能力(网络容量)的数据
- 网络层路由协议不能充分使用网络资源、不能适应流量的分布变化
- 网络资源不足以支持流量
拥塞控制的基本原理
1. 监视系统 Monitor the system
持续观察网络运行状态
2. 检测拥塞 Detect congestion
判断拥塞是否发生,以及拥塞发生在什么时间、什么位置。
3. 传递拥塞信息 Pass information
把拥塞信息传递给能够采取措施的地方,比如源主机、路由器或网络控制机制。
4. 调整系统运行 Adjust operation
根据拥塞情况采取措施,例如降低发送速率、改变路由、丢弃部分分组、进行流量整形等,从而缓解或消除拥塞。
拥塞控制的途径
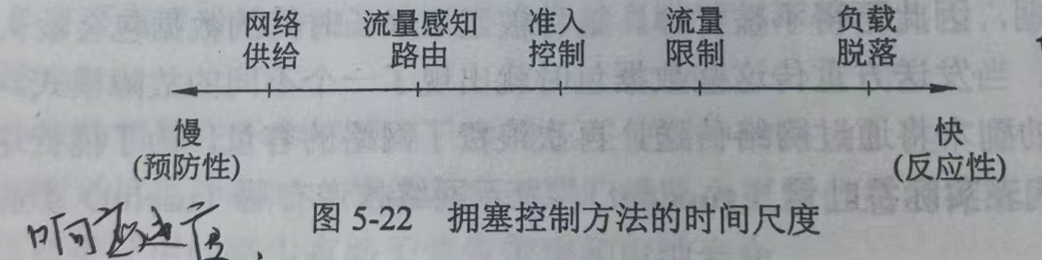 预先避免拥塞/一旦发生拥塞随之做出反应
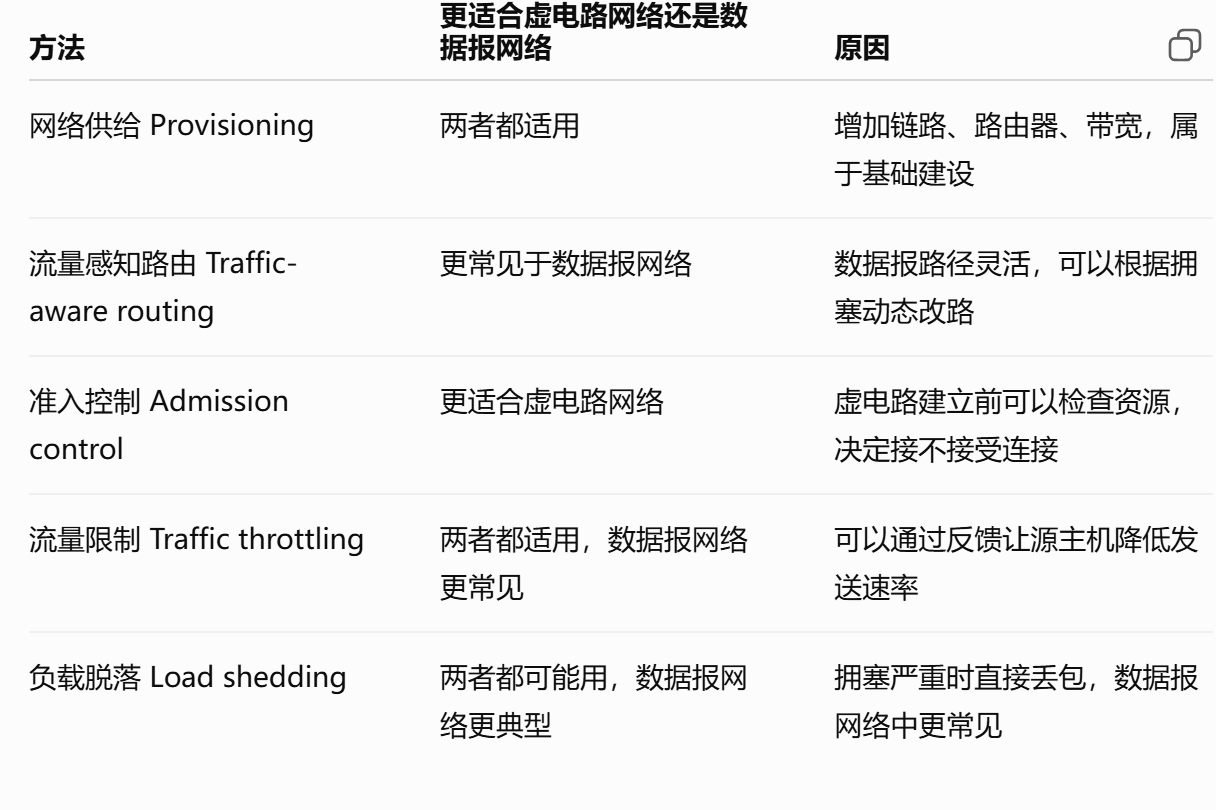
- 网络供给provisioning:建立一个与流量相匹配的网络
- 流量感知路由traffic-aware routing
- 改变最短路径的权重以改变数据分组的路由,使远离频繁使用的路径
- 准入控制 admission control
- 降低负载
- 在一个虚电路网络中,如果新的连接将导致网络变得拥挤不堪,那么就应该拒绝这种新连接的建立
- 流量限制
- 给造成问题的数据分组的源端传递反馈消息,要求这些源端抑制流量/减缓流量本身
- 负载脱落 load shedding
- 网络不得不丢弃无法传递的数据包
流量感知路由
方式:把链路权重设置成一个固定链路带宽、传输延迟、可变测量负载或平均排队延迟的函数
- 在其他条件都相同的情况下,最小权重的路径更青睐轻负载的路径
- 使新的流量绕开负载较重的热点区域
实时改变路由会引发路由震荡
- 尝试在路由权重中包括负载但将其限定在一个狭窄的范围
- 多路径路由
- 把流量慢慢迁移 流量工程:在路由协议外部通过慢慢改变它的输入来调整路由 网络根据当前的流量情况,主动调整数据分组的转发路径,使网络资源利用更均衡、拥塞更少、服务质量更好。
准入控制
基本思想:除非网络可以携带额外的流量而不会变得拥塞,否则不再建立新的虚电路连接
- 广泛应用于虚电路网络
- 可以和流量感知路由算法结合,即为新的连接寻找一条负载较轻的路径
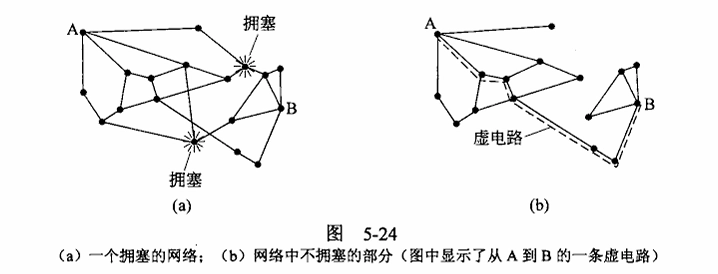
流量调节
限制流量的方法
- 路由器必须确定何时快要接近拥塞
- 每个路由器连续检测正在使用的资源➡️在路由器内缓冲的排队数据分组长度
- 路由器必须及时把反馈信息传递给造成拥塞的发送方,具体的一些反馈机制
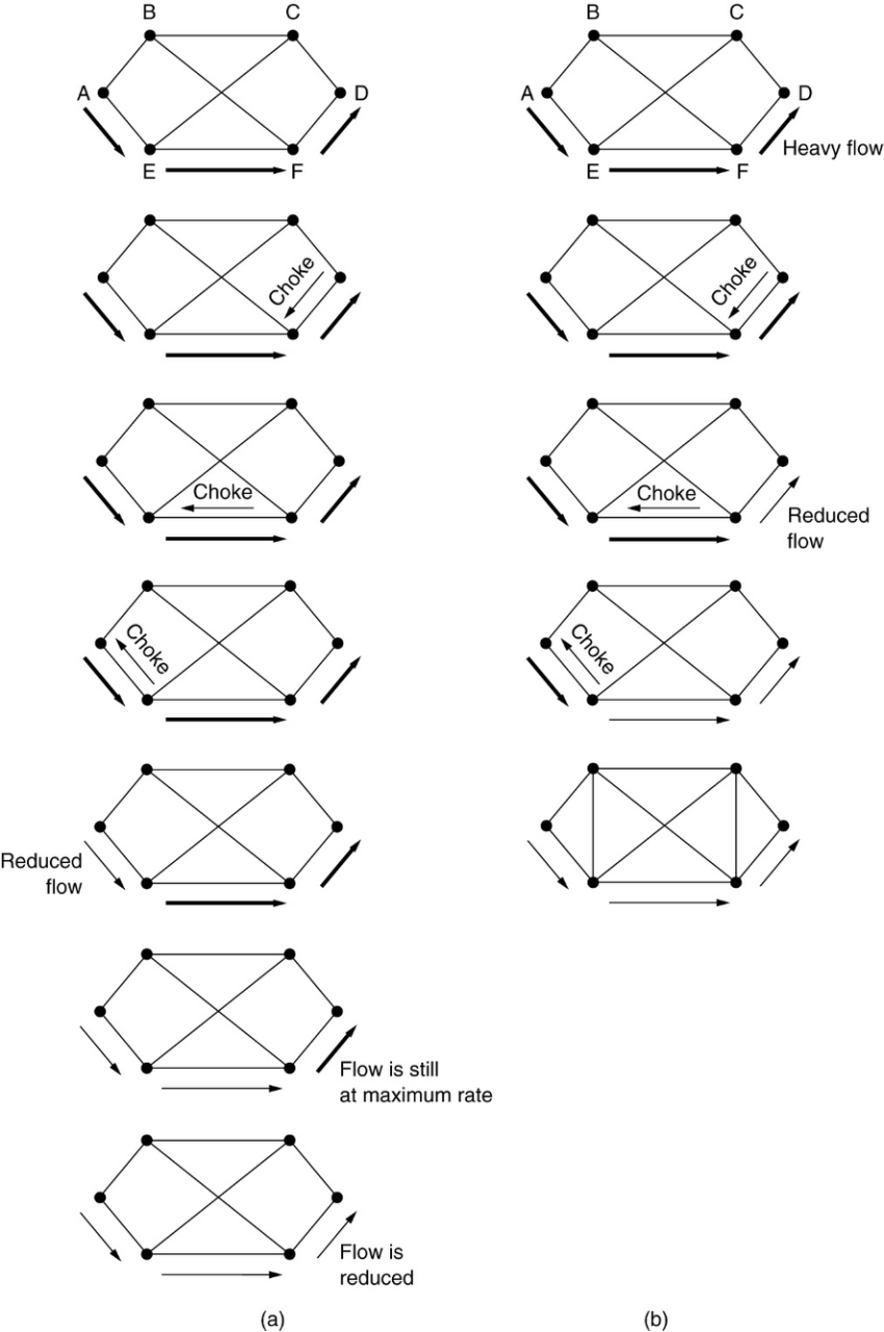
- 抑制包choke packet
- 通知拥塞发送方的最直接方式是直接告诉发送方。在这种方法中,路由器选择一个被拥塞的数据包,给该数据包的源主机返回一个抑制包(choke packet)
- 在原来的拥塞数据包上添加一个标记(设置头部中的一位)——在前行的路上不会产生更多的抑制包
- 当源主机收到了抑制包,按照要求它必须减少发送给指定目标的流量
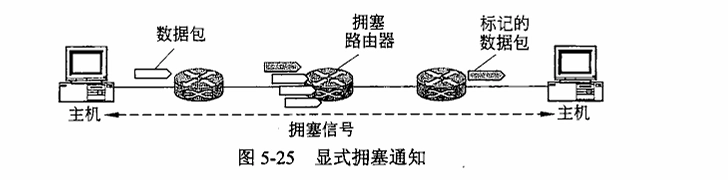
- 显示拥塞通知(ECN, Explicit Congestion Notification)
- 路由器可以在它转发的任何数据包上打上标记(设置数据分组头部的某一个标志位)发出信号,表明正在经历着拥塞
- 当网络传递数据包时,接收方可以注意到有个拥塞已经发生,在它发送应答包时顺便告知对方,然后发送方可以像以前一样减低传输速率
- 逐条后压Hop-by-Hop
- 让抑制包在沿途中的每一跳都发挥作用
- 效果:拥塞点上的拥塞现象很快得到了缓解,但是其代价是上游路径需要消耗更多的缓冲区空间
- 抑制包choke packet
负载脱落
负载脱落:当路由器因为来不及处理数据包而面临被这些数据包淹没的危险时,就将它们丢弃 如何选择丢弃哪个数据包?
- 根据网络的应用程序类型
- 设置不同的分组选择策略:对文件传输而言,旧的分组更好,选择丢弃新的分组;对语音通信而言,新的分组更好,选择丢弃旧的分组。
- 设定由用户完成,如何刺激大家选择合适的优先级不容易
- 随机早停检测(RED,Random Early Detection)
- 思想;在所有缓冲区空间真正耗尽之前,就开始丢弃分组
- 做法:为了确定何时开始丢弃数据分组,路由器要维护一个运行队列长度的平均值,当某条链路上的平均队列长度超过某个阈值时,该链路就被认为即将拥塞,因此路由器随机丢弃一小部分数据分组
- 随机选择丢弃的数据分组使得快速发送方发现丢包的可能性更大
- 在数据包网络中,路由器不能分辨出哪个源引起了网络的最大麻烦
- 随机选择丢弃的数据分组使得快速发送方发现丢包的可能性更大
- 当没有期待的确认信息时,受此影响的发送方就会发现丢包了,然后传输协议将放慢速度
- 丢失的数据包起到了抑制包的同样作用,但却是隐含的,无需发送任何显式信号
- RED用在主机不能接收显式信号的环境里
5.4 服务质量
Quality of Service QoS
一个简单实用的解决方案:过度配置(overprovisioning)
- 建设有足够容量的网络
- 问题:成本昂贵+基于预期的流量模式(无法在流量模式变化很大的情况下保证网络的预期性能)
确保服务质量必须解决的四个问题:
- 应用程序需要网络什么流量
- 如何规范进入网络的流量
- 为了保障性能如何在路由器预留资源
- 网络能否安全地接收更多流量
应用需求
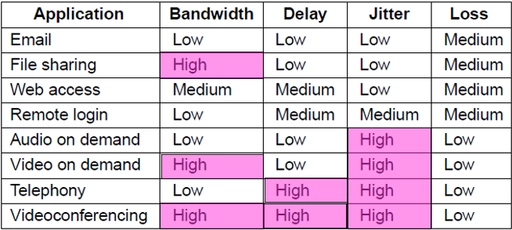
从一个源端到一个接收方的数据分组流称为一个流flow 每个流的需求可由四个主要参数表示:
- 带宽、延迟、抖动、丢失
- 这些参数决定了一个流要求的服务质量
下表体现应用程序服务质量需求的严格程度:
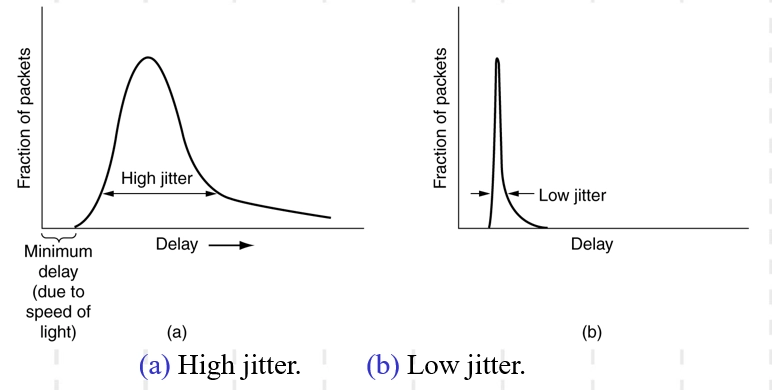
Jitter Control 抖动控制
延迟的变化(即标准方差)或者数据包到达时间的变化称为抖动Jitter
流量整形
流量整形traffic shaping:调节进入网络的数据流的平均速率和突发性所采用的技术
- 目标:允许应用程序发送适合它们需求的各种各样的流量,包括带有某种程度的突发,但要有一个简单而有用的方式向网络描述可能的流量模式
- 服务等级约定(SLA,service level agreement):客户和服务提供者之间的约定 流量监管traffic policing:对一个流进行监测
- 超出约定模式之外的数据包可能会被丢弃或者被打上低优先级的标签
流量整形和流量监管对于实时数据传输有非常重大的影响
漏桶和令牌桶
拥塞的主要原因:通信量的突发性 漏桶和令牌桶是网络中用于流量整形的主要方法
一方面,它可以平滑路由器之间的流量,使突发流量变成较稳定的输出;另一方面,它也可以调节主机的发送速率,限制主机向网络注入过多数据,从而减少拥塞
| 整形数据包 | 漏桶和令牌桶示例 |
|---|---|
 |
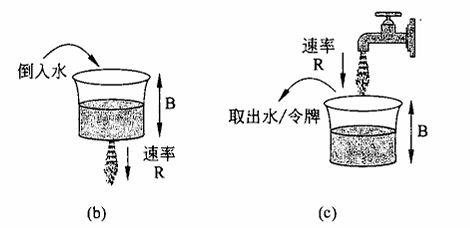 The Leaky Bucket Algorithm The Token Bucket Algorithm |
| 漏桶算法The Leaky Bucket Algorithm | |
| 漏桶可以应用到注入网络的数据包上,对其进行整形和监管。 |
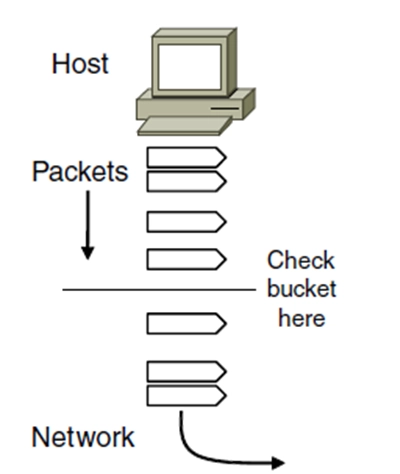
- 概念上,每个主机连接到网络的接口中包含一个漏桶。为了向网络发送数据包,必须有可能往漏桶中灌入更多的水。➡️对主机进入网络的流量实施整形
- 如果漏桶满时来了一个数据包,那么该数据必须排入队列等漏桶空出来再接纳或者被丢弃➡️用在服务提供商的网络接口,通过硬件对进入网络的流量实施监管
- 漏桶的工作原理: ① 在每个主机连接到网络的接口处都包含一个漏桶,即一个有限长度的内部队列。 ② 当一个分组到来时,如果队列中还有空间,就把该分组加入队列尾部。如果当队列满的时候,又有一个分组到来,则该分组被抛弃/等漏桶空出来再接纳 ③ 每经过一个常数时间才允许把一个分组放到网络上 ④ 这种机制可以将主机内用户进程发送出来的一个不均匀分组流变成网络上的一个均匀分组流,把突发的分组流变得很平滑,从而降低了拥塞的几率 ⑤ 无论负载突发性如何,漏桶算法都强迫输出按平均速率进行。 补充:字节计数漏桶算法(按字节计数) 字节计数漏桶算法 是一种基于字节的漏桶算法。
- 在每一个时钟滴答到来时,一个计数器被初始化为 n
- 如果队列首部的第一个分组长度小于 n 字节,就发送这个分组,并从计数器中减去该分组的字节数
- 如果计数器还有剩余,系统可以继续发送后面的分组
- 当计数器剩余值小于队列中下一个分组的长度时,本轮发送停止,直到下一个时钟到来
令牌桶算法The Token Bucket Algorithm
把网络接口想象成一个桶,正在往里面灌水,水龙头速率R,水桶容量B。为了发送一个数据包,我们必须能够从桶中取出水或令牌token。桶内只有固定数量的令牌,可以理解为B。如果桶是空的,我们必须等待更多的令牌到达才能发送另一个数据包
通俗的版本:
系统以固定速率 R 向桶中加入令牌,桶的最大容量为 B。发送数据包前必须先获得相应数量的令牌;若桶中令牌足够,则允许发送并消耗令牌;若桶为空,则必须等待新的令牌产生后才能发送。
2. 令牌桶工作原理:
① 漏桶中保存的是令牌,这些令牌由时钟产生,每隔T产生一个
② 要使一个分组被传送出去它就必须要抓住并销毁一个令牌
③ 令牌桶允许将令牌(即许可权)保存起来,直至达到桶的最大容量B
④ 当令牌桶满后,令牌桶丢弃令牌,不丢弃分组
⑤ 从本质上讲,令牌桶所做的事情是:允许突发流量但是不得超过一个预定的最大值
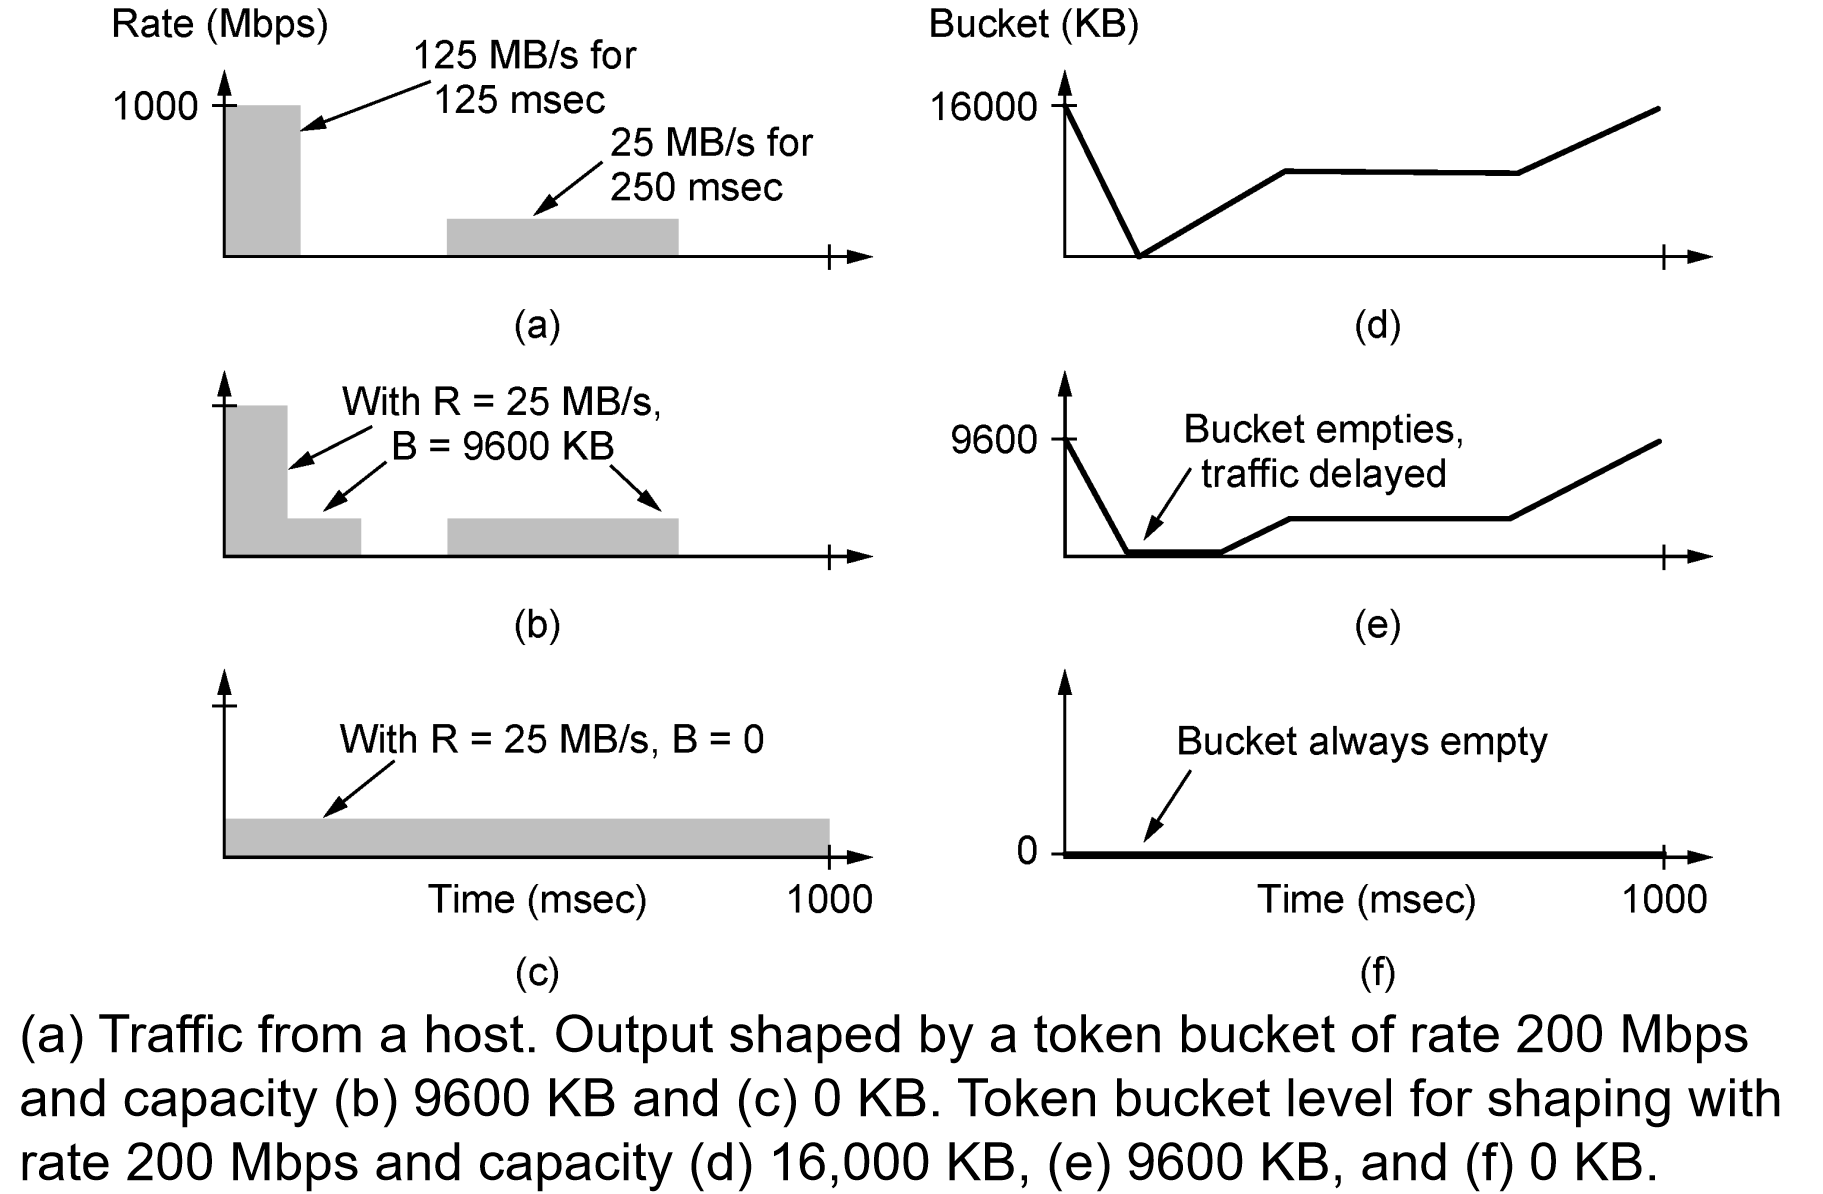
- (c)给出极端情况:流量被完全平滑了:不允许任何突发,并且流量以一个稳定速率进入网络
计算题:令牌桶允许一次突发发送多久 突发长度S秒,最大输出速率M B/s,令牌桶的容量为B字节,令牌到达率/令牌生成速度为R B/s
- 突发输出最多可包含:B+RS
- MS=B+RS➡️S=B/(M-R)
- 区别: ① 流量整形策略不同:漏桶法不允许将空闲的主机许可权保存起来以便将来发送更大的突发数据,而令牌法则允许将许可权保存起来,直至达到桶的最大容量 ② 丢弃对象不同:当令牌桶满了之后,丢弃令牌,但是不丢弃分组;相反的,在漏桶算法中丢弃分组
包调度
包调度算法Packet Scheduling:在同一个流的数据包之间以及在竞争流之间分配路由器资源的算法。 为不同的流预约的潜在资源:
- 带宽Bandwidth:对任何一条输出线路都不能超额预订
- 缓冲区Buffer space
- 当一个数据包抵达时,它通常被保留在路由器的缓冲区直到可以从选择的输出线路上发送出去。如果没有可用的缓冲区,那么该数据包不得不被丢弃,因为没有地方可以存放数据包
- 可以为某个特定的流预留一定的缓冲区,从而该流不必跟其他的流争用缓冲区。只要该流需要,总能获得可用的缓冲区,直到达到某个最大的限额
- CPU周期CPU cycles
- 可以得到CPU更快的处理
数据包调度算法:确定下一次将缓冲区中的哪些数据包发送到输出线路
- FIFO (FCFS)先入先出/先到先服务
- 每个路由器把需要转发的数据分组排入相应的输出线路的队列,直到它们可以发送并且发送顺序与到达队列的顺序相同
- Drop tail尾丢包:当路由器的缓存队列已经满时,后续到达的数据分组无法再进入队列,因此会被直接丢弃。由于被丢弃的是队列尾部新到达、尚未入队的数据包,所以这种队列管理方式称为尾丢包。
- 易于实现但是无法提供良好的服务质量
- 当存在多个流时,一个流很容易影响到其他流量的性能(第一个流发送很大的突发数据包)
- Fair queueing公平队列
-
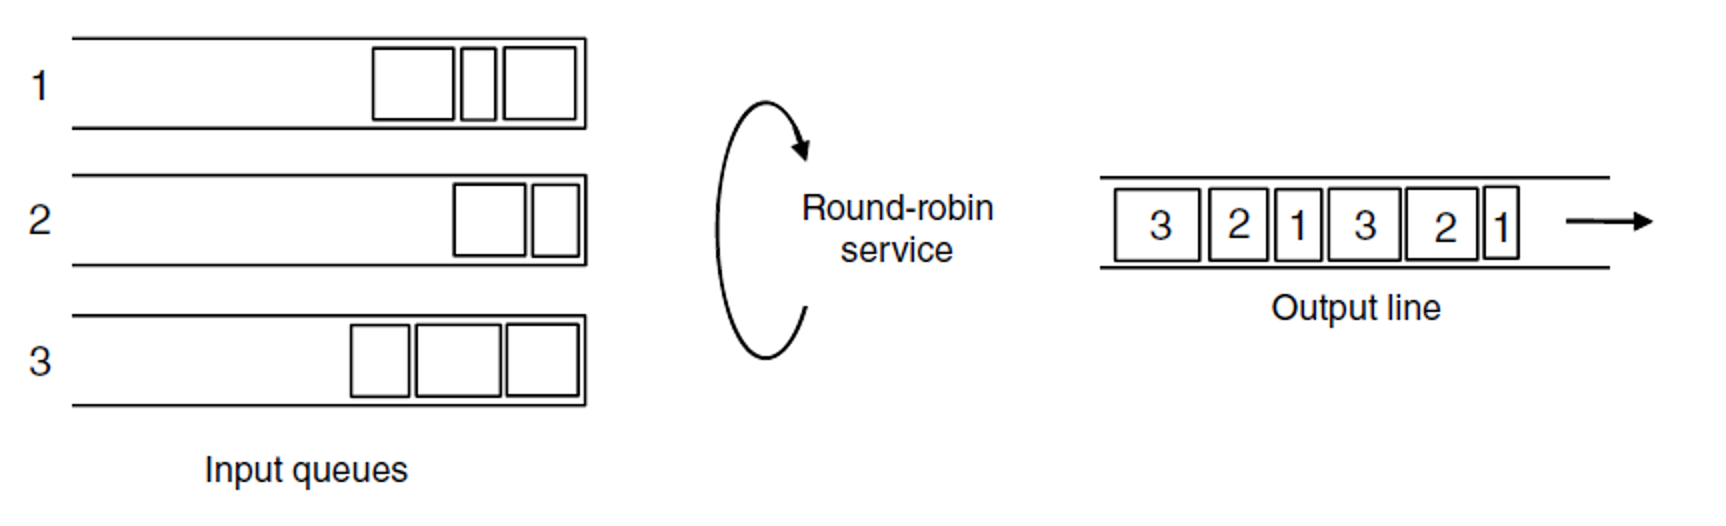
针对每条输出线路,路由器为每个流设置单独的队列
- 当队列空闲时,路由器循环扫描各个队列,然后从下一个队列中取出第一个数据包发送
- 当队列空闲时,路由器循环扫描各个队列,然后从下一个队列中取出第一个数据包发送
-
算法缺陷:它给使用大数据包的主机比使用小数据包的主机提供了更多的带宽
-
改进:从数据包接数据包➡️字节接字节
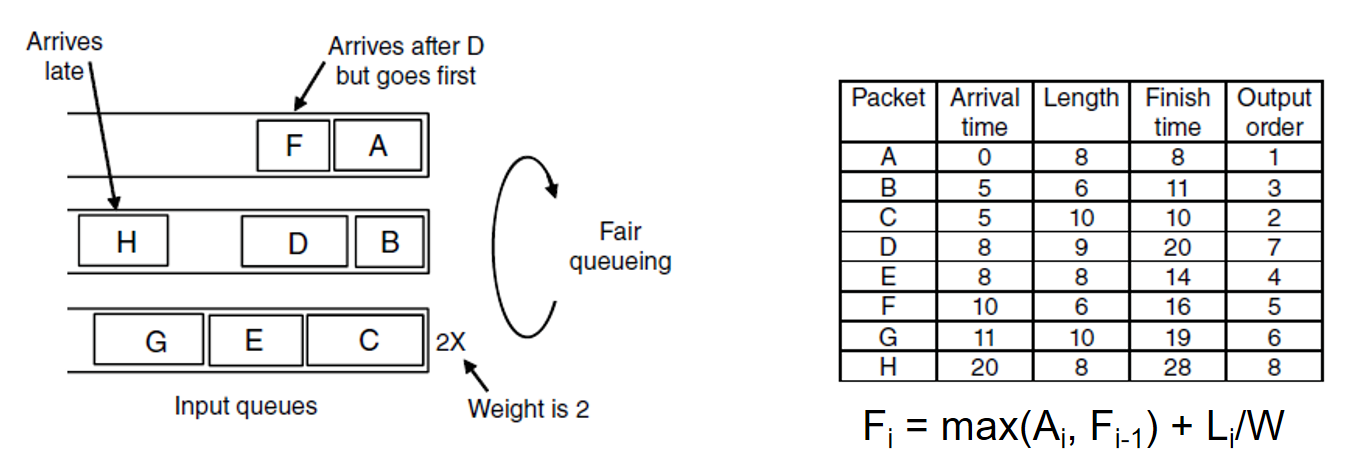
- 计算一个虚拟时间——每个数据包发送完毕所需要的轮数(在当前的队列中)
- 假设每一轮循环从所有有数据待发送的队列中排空一个字节我们据此计算虚拟时间,然后按照数据包的结束时间顺序排队,并以该顺序真正发送数据包
- Fair Queueing 用“按字节轮转”的思想计算虚拟完成时间,但实际输出链路上仍以完整数据包为单位发送
- 改进:加权公平队列WFQ (Weighted Fair Queueing):给流赋予不同的权重
- 计算一个虚拟时间——每个数据包发送完毕所需要的轮数(在当前的队列中)
-
5.5 网络互联
网络互联nterconnectnet:当两个或多个网络连接起来形成网络互联
隧道
处理情形:源主机和目标主机所在网络的类型完全相同,但它们中间却隔着一个不同类型的网络 隧道技术Tunneling:把一种协议的数据包,封装进另一种协议的数据包里,让它能够穿过原本不支持它的网络;到达隧道出口后,再把原来的数据包取出来继续转发
路由器由一个IPv6数据包放入到一个IPv4数据包中,当这个包裹着的数据包到达伦敦路由器时,原来的IPv6数据包被提取出来,并被发送给最终的目标主机
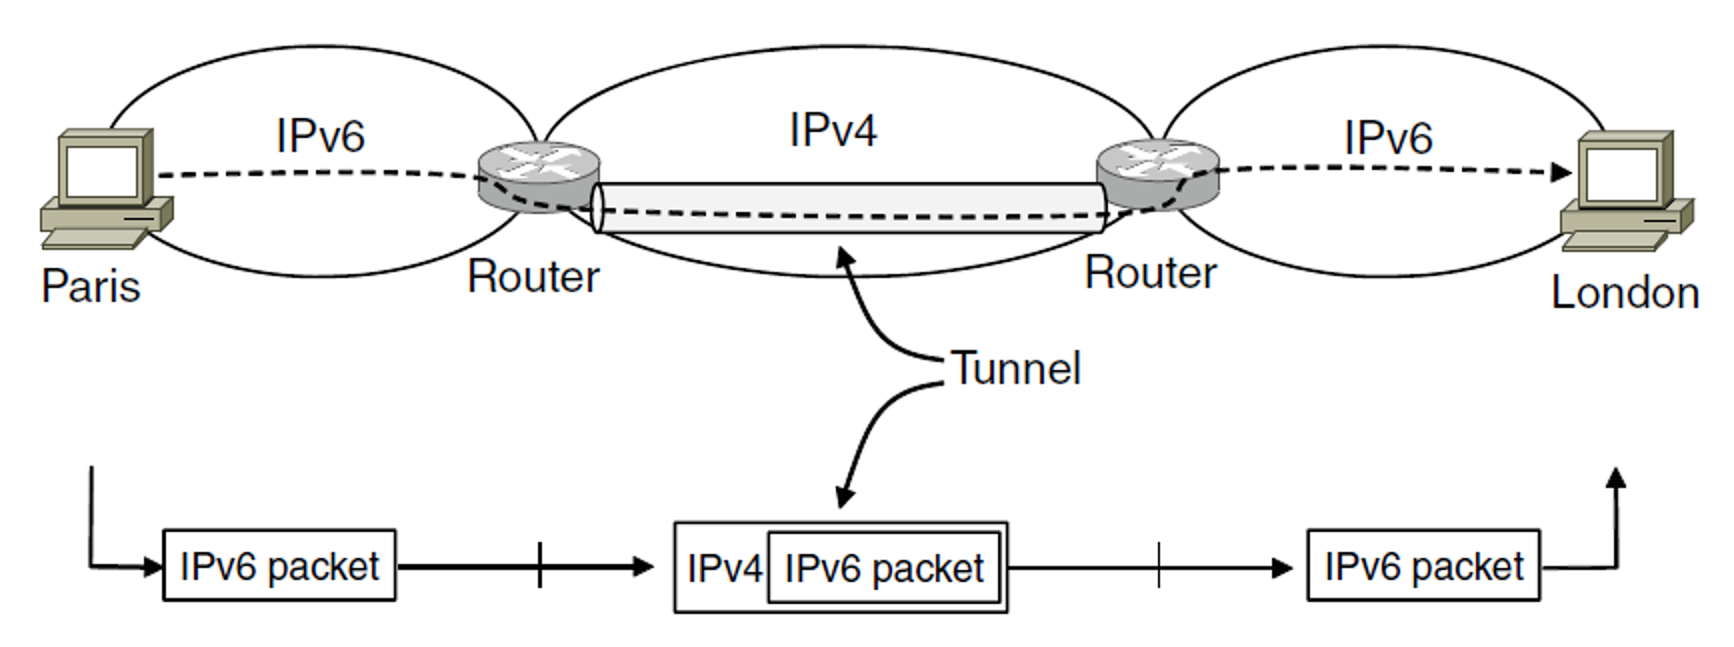
隧道被广泛用于连接那些因使用其他网络而被隔离的主机和网络。结果生成的网络就是覆盖overlay网络,因为它有效的覆盖在了基础网络之上
- 缺点:无法到达位于隧道之下网络的主机
- 隧道连接的是两个隧道端点之间的 overlay 网络,隧道里的数据包通常只关注隧道出口后的目标网络,而不是中间底层网络里的普通主机
5.6 Internet网络层
Internet协议(Internet Protocol):将整个Internet黏合在一起的网络层协议
- IP的任务是提供一种尽力而为(best-effort)地把数据包从源端传输到接收方的方法(不提供任何保障),无需考虑这些机器是否在一个网络,也不必关心它们之间是否还有其他网络
Internet的通信过程:
- 传输层获取数据流,并且把数据流拆分成段,以便作为IP数据包发送。
- IP路由器转发每个数据包穿过Internet,沿着一条路径把数据包从一个路由器转发至另一个路由器,直到数据包到达目的地。
- 在接收方,网路层将数据传给传输层,再由传输层交给接收进程。(当所有的数据段最终都抵达目标机器,它们被网络层重新组装还原成最初的数据报,然后该数据报被网络层传给传输层)
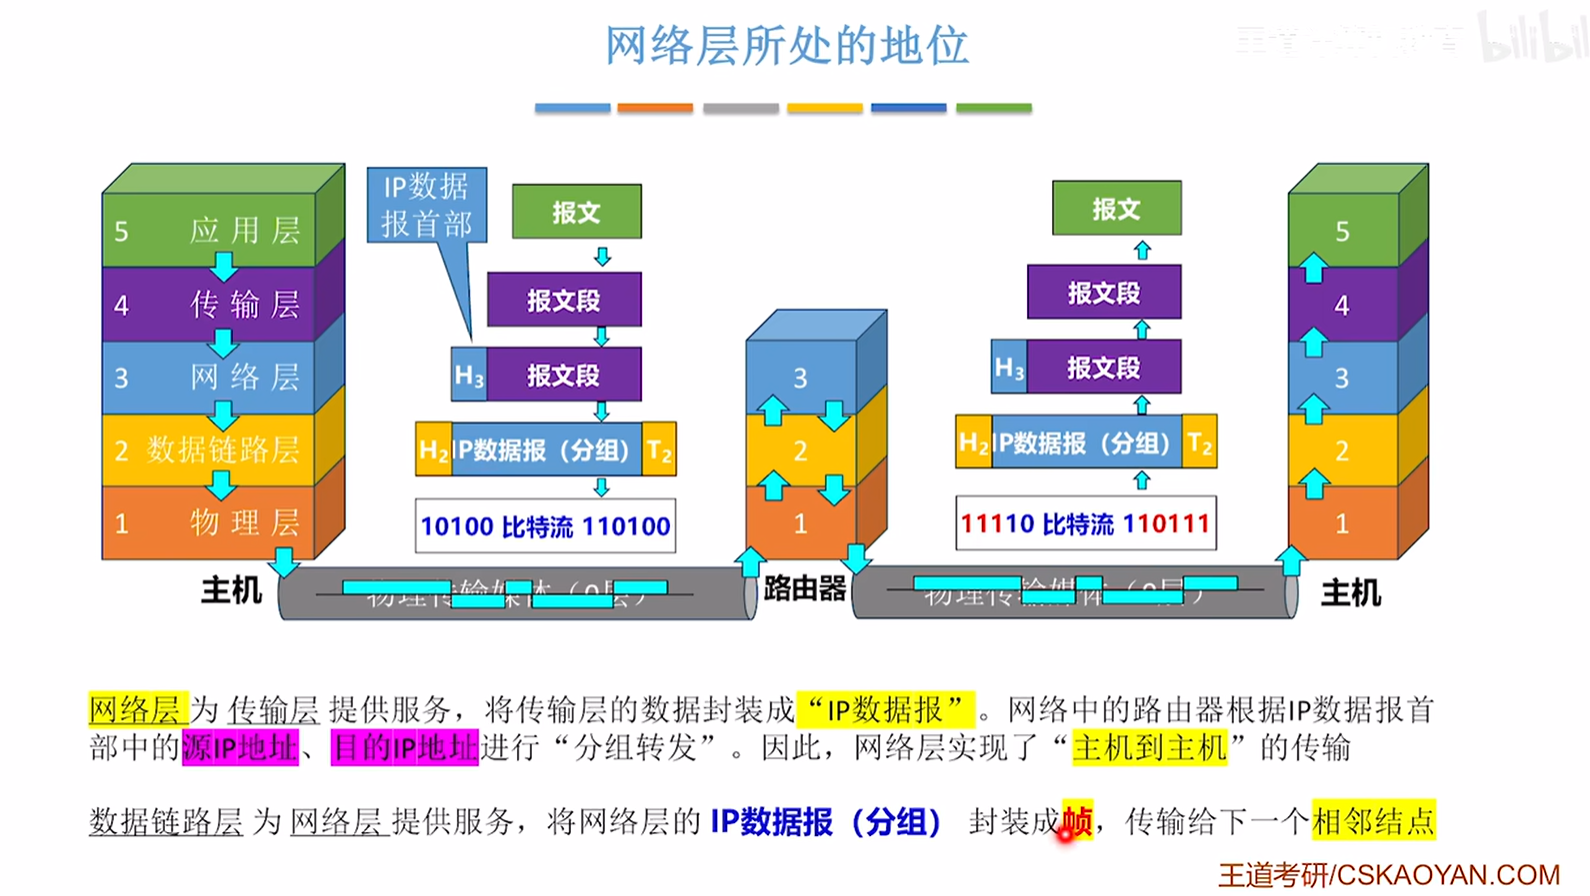 Internet的通信过程:
IPv4协议
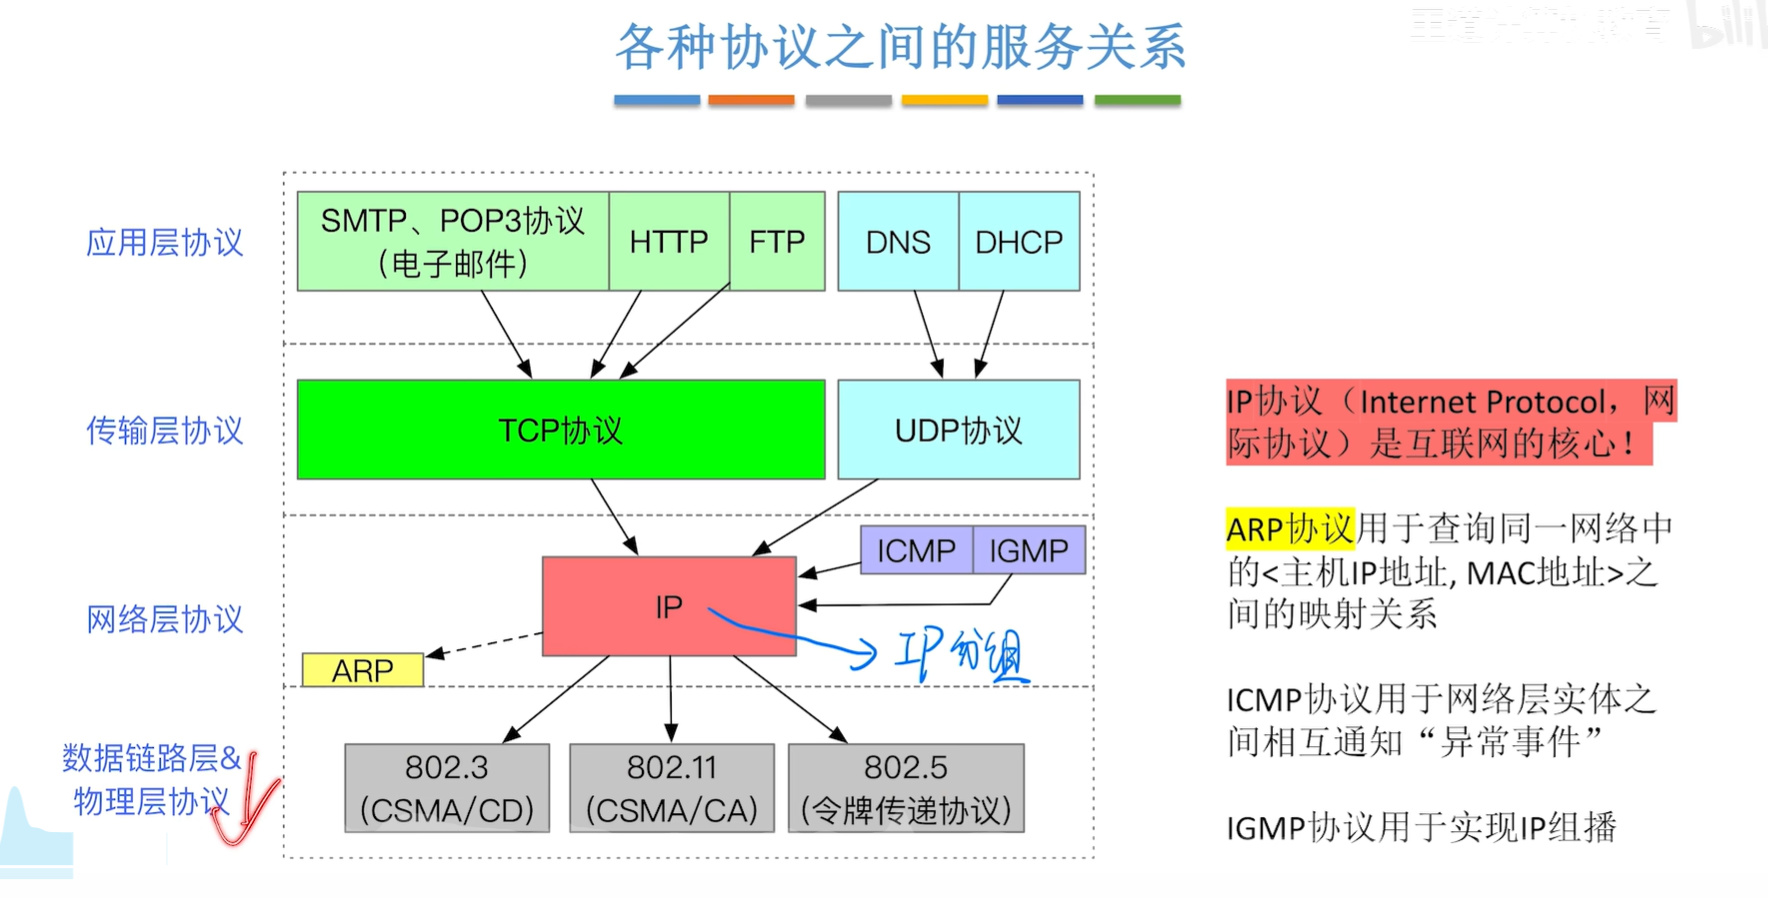
IP数据报的分片问题
- 一个链路层数据帧能承载的最大数据量称为最大传送单元MTU
- 如果一个IP数据报的总长度超出了下一段链路的MTU,就需要将数据部分进行分片
- 以太网的MTU=1500B
注:每个分片都是一个可以被单独转发的IP数据报,都包含头部
- IP数据报的分片可能在源主机、或任何一个路由器中发生
- 只有目的主机才会对分片进行重组
- 各分片有可能乱序到达目的主机
- 由于首部的片偏移以×8为单位,因此除了最后一个分片外,其每个分片的数据部分必须是8B的整数倍
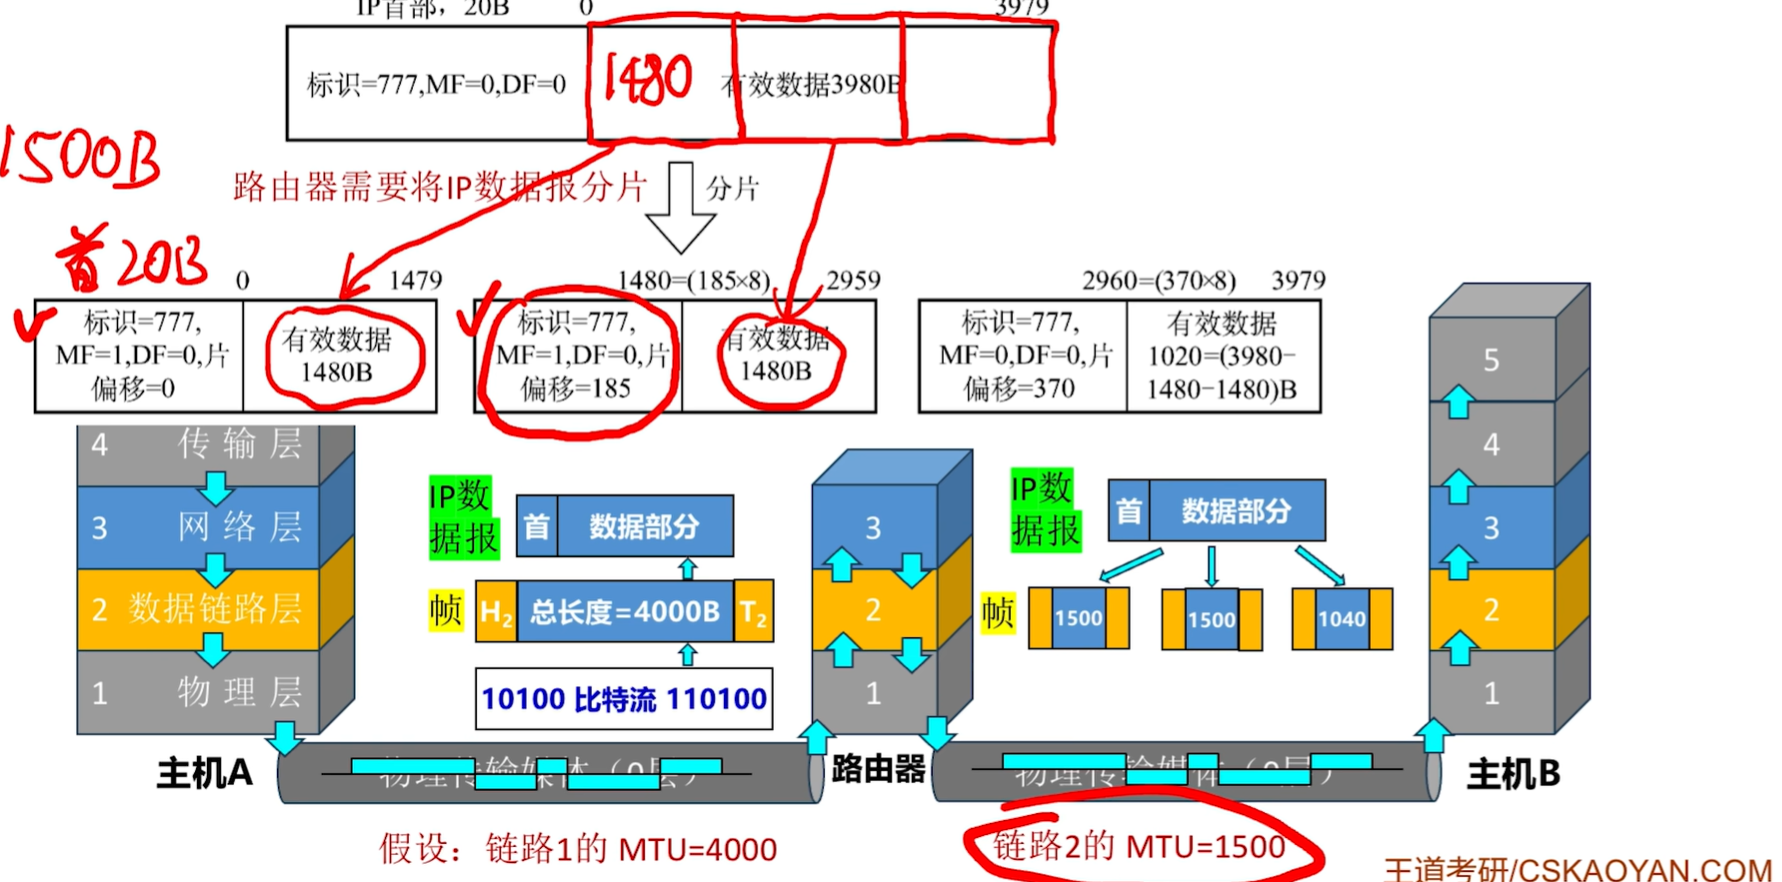 注:每个分片都是一个可以被单独转发的IP数据报,都包含头部
IP数据包(IP分组)的格式:
- 首部/头部
- 固定部分 20B+ 可变部分 0~40B
- 最短20B
- 最长
- 正文:有效净荷/数据部分
- 理论最短=0B
- 理论最长=65535-20=65515B
- 实际传输过程中数据部分的长度受到下一段链路的最短/最长帧长限制
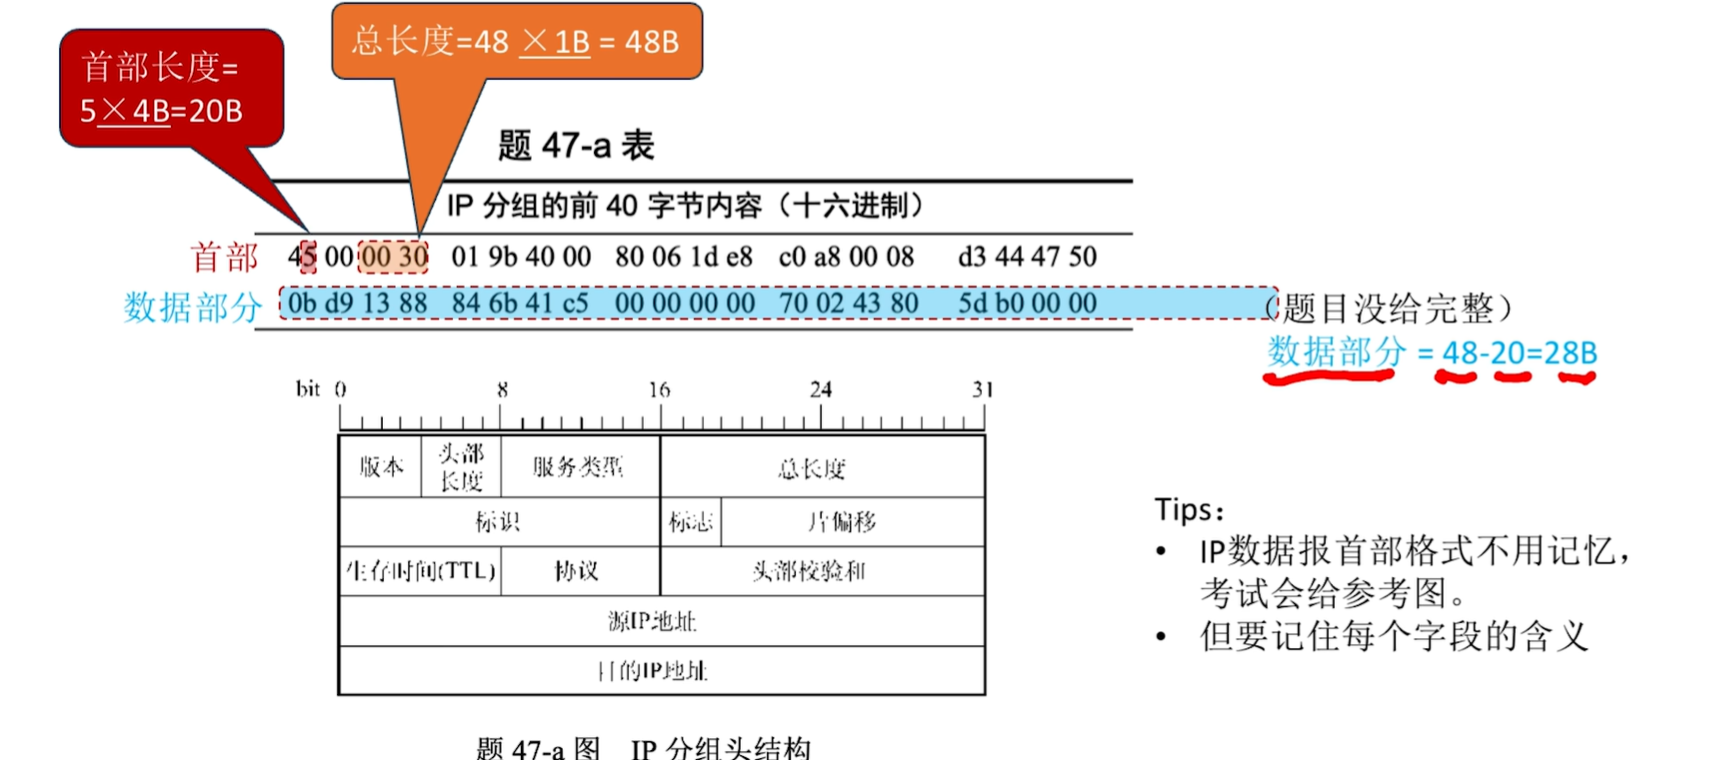
IPv4头部字段:
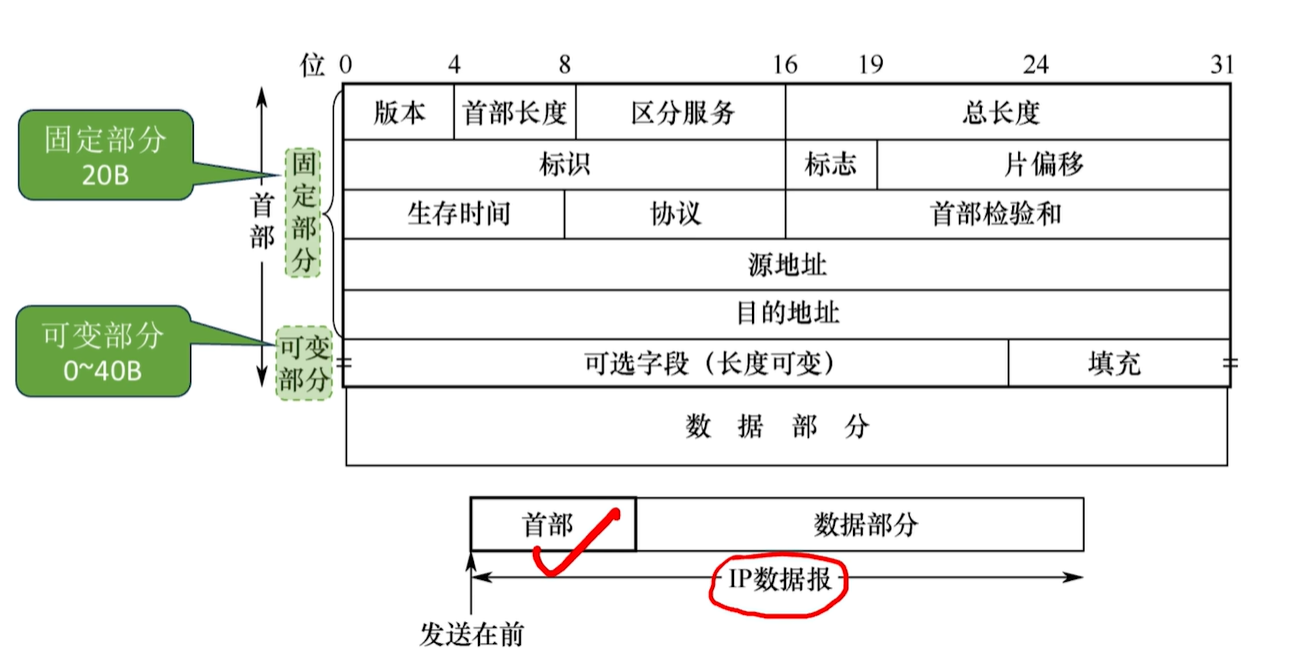 固定部分:
第一行:
- 版本4bit:用于区分网络层使用的IP协议版本(v4、v6)
- 首部长度4bit:4bit表示0-15,以×4B为单位
- 区分服务8bit:最初服务类型字段(Type of service)包含6位,现在前6位用来标记数据包的服务类型,后2位用来携带显式拥塞通知ECN信息
- 总长度16bit:包含首部+数据部分
- 0-65535,以×1B为单位 第二行:
- 标识16bit:让主机确定一个新到达的分段属于哪一个数据报,同一个数据报的所有段包含相同的标识值
- 由IP数据报的源主机生成,通常是自增序列
- 若标识和源地址相同说明是同一个数据报
- 标志3bit
- 最低位MF More Fragment
- MF=1 表示后面还有分片
- MF=0 表示这是最后一个分片
- 次低位DF Don't Fragment
- DF=1 表示不允许被分片
- DF=0 表示允许被分片
- 最高位不用管
- 最低位MF More Fragment
- 片偏移13bit:表示数据部分在被分片前的位置
- 以×8B为单位 第三行:
- 生存时间TTL 8bit:限制数据包生存期的计数器。 数据报在网络中可通过的路由器数的最大值
- TTL的初始值通常由源主机设置
- 每经过一个路由器,路由器就将TTL-1,如果TTL减到0,就直接丢弃分组,并向源主机发送ICMP报文
- ICMP报文用于通知一个节点发生了某种异常
- 协议8bit:指明应该交给哪个传输进程
- TCP协议:6
- UDP协议:17
- 首部校验和16bit
- 每个路由器仅校验首部,而不校验数据部分
- 如果该字段全0,代表不校验 第四、五行: 源地址、目的地址各32bit:
- 分别代表发送方的IP地址和接收方的IP地址
可变部分Options:为了凑足4B的整数倍需要进行填充
IP地址
Internet上每台主机和每个路由器都有一个IP地址(32bit) 一个IP地址并不真正指向一台主机,而是指向一个网络接口
- IP地址是逻辑地址(不是物理地址)
- 包含网络号和主机号
- IP地址必须统一分配
- 两个重要特性:
- 每台主机分配了一个唯一的地址
- 网络标识号的分配必须全球统一,但主机号可由本地分配,不需全球一致
IP地址的格式:点分十进制法 在IPv4中,IP地址由四个八位域(叫作octets)组成。Octets被点号分开代表0-255范围内的十进制数字。用二进制格式时共有32位组成,为了方便记忆,用点号每八位一分割,称为点分十进制
- 按照惯例,IP地址的书写格式后跟一个斜线,斜线后面是网络部分的位长度
分类和特殊寻址
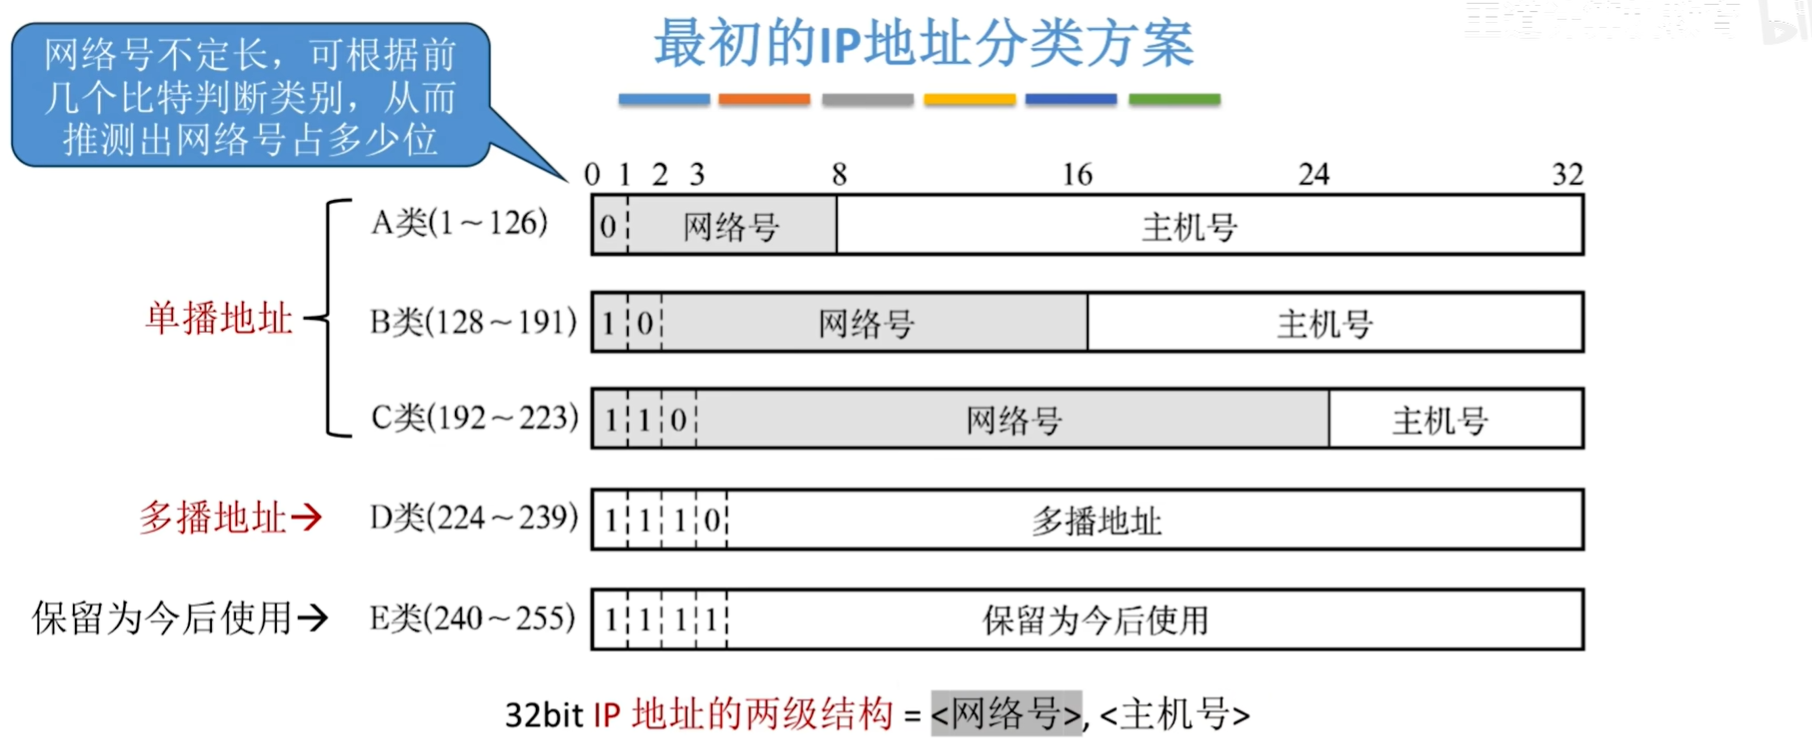
- 分类
- A\B\C类地址——单播地址(可通俗理解为QQ号)
- D类地址——多播地址(可通俗理解为QQ群号)
- 网络号不定长,可根据IP地址的前几个比他判断类别,从而推测出网络号占多少位
- A:0 ➡️1~126 网络号8位
- B:10 ➡️128-191 网络号16位
- C:110 ➡️192-223 网络号24位
- D:1110 ➡️224-239
- E:1111 ➡️240-255
- 从属于同一个网络的所有主机、路由器接口的IP地址网络号都相同
- 当一个新主机接入网络时,需要给它分配一个IP地址、并配置默认网关 中国大陆是否存在真正的A类IP地址?否
特殊用途的IP地址
以下的这些特殊地址都不能指派给任何一台主机或路由器私用
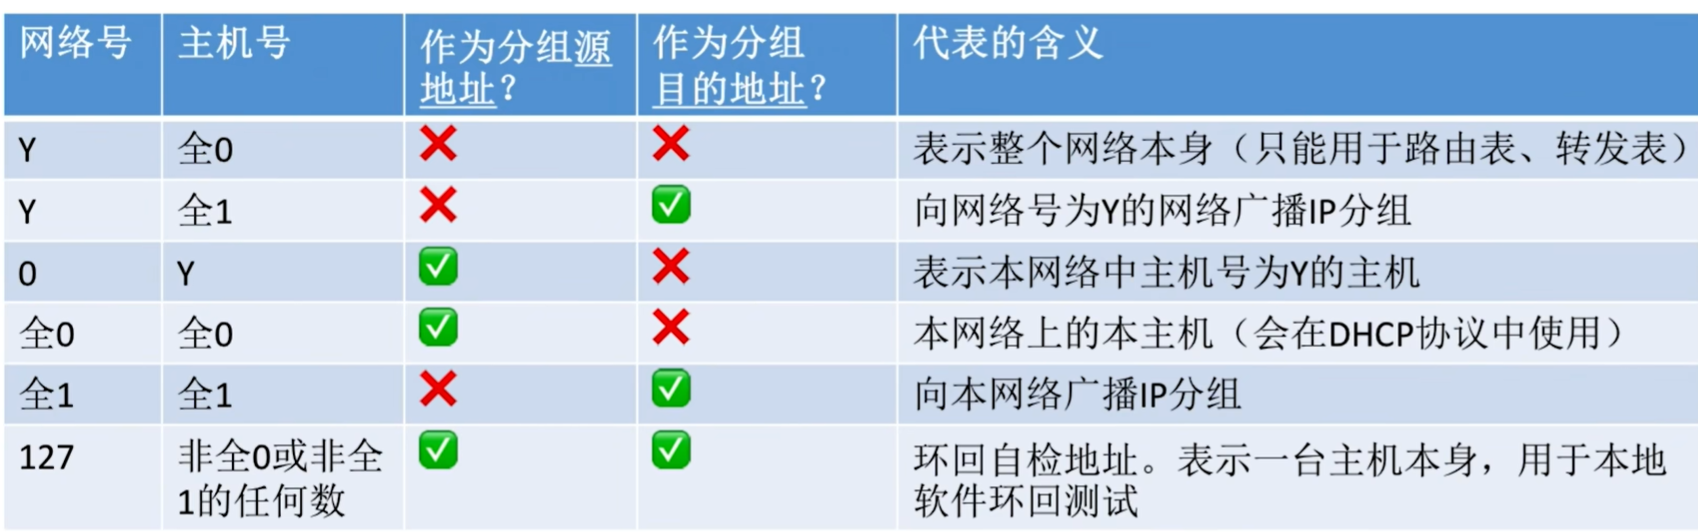 如果一个网络中,主机号占N个bit,那么这个网络中,最多支持
子网划分与子网掩码
前缀(可以不看)
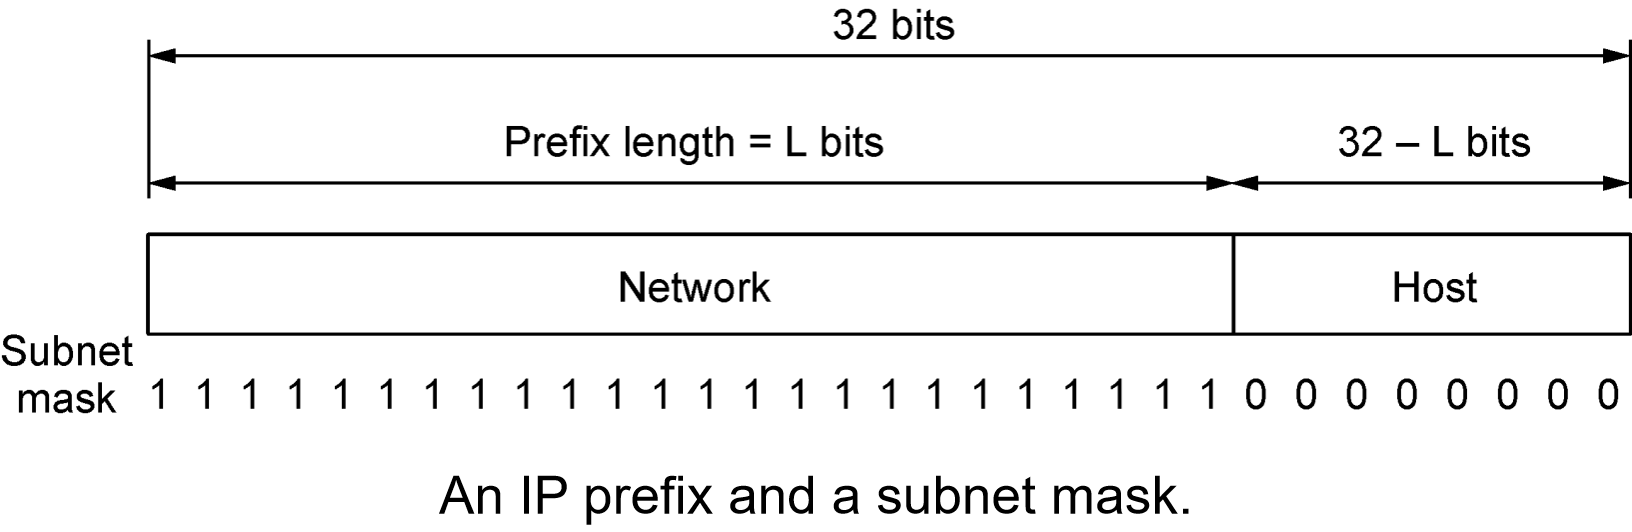
IP地址具有层次性,每个32位地址由高位的可变长网络和低位的主机两部分数据组成
- 同一网络上的所有主机,其地址的网络值是相同的
- 前缀:一个网络对应一块连续的IP地址空间,这块地址空间就称为地址的前缀(其实就是王道课上讲的<网络号,主机号>)
子网划分技术:
子网:分割一个大型网络得到的一系列结果网络称为子网
子网划分的原理:若某单位租用了一个IP地址段,假设原本主机号 n bit,那么就可以将前 k bit抠出来作为子网号,用剩余的n-k bit作为主机号,这样就能划分出
- 子网划分前 IP地址为两级结构<网络号,主机号>
- 子网划分后 IP地址为三级结构<网络号,子网号,主机号>
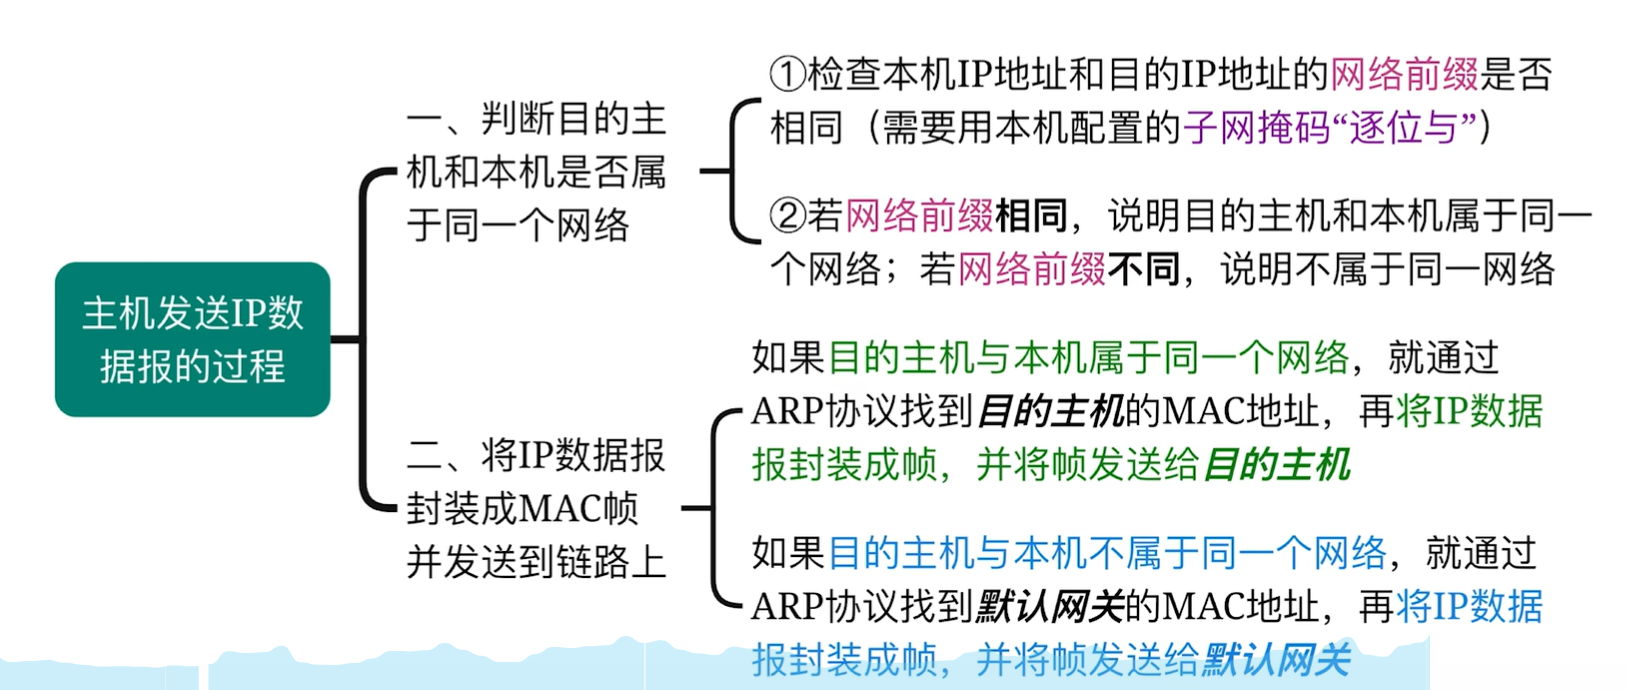
子网掩码: 在进行子网划分后,用子网掩码和IP地址"逐位相与",算出<网络号,子网号>,比较是否处于同一个网络(可合称为网络前缀)
补充:将子网掩码取反再与IP地址逻辑与(AND)后得到的结果即为主机部分
- 只有网络前缀相同的IP地址,才归属于同一个网络(或子网)
- 子网掩码表示方法
- <网络号,子网号>的位置为1,对应主机号的位置为0
- 常使用点分整数表示法来表示子网掩码
- eg:11111111 11111111 11111100 00000000➡️255.255.255.0
- 标记位长:/22
- 子网号与主机号的分界(1和0的分界) 注意:
- <网络号,子网号>的位置为1,对应主机号的位置为0
- 如果一个网络内部进行了子网划分,那么这个网络中的每台主机、每个路由器都需要配置IP地址、默认网关、子网掩码
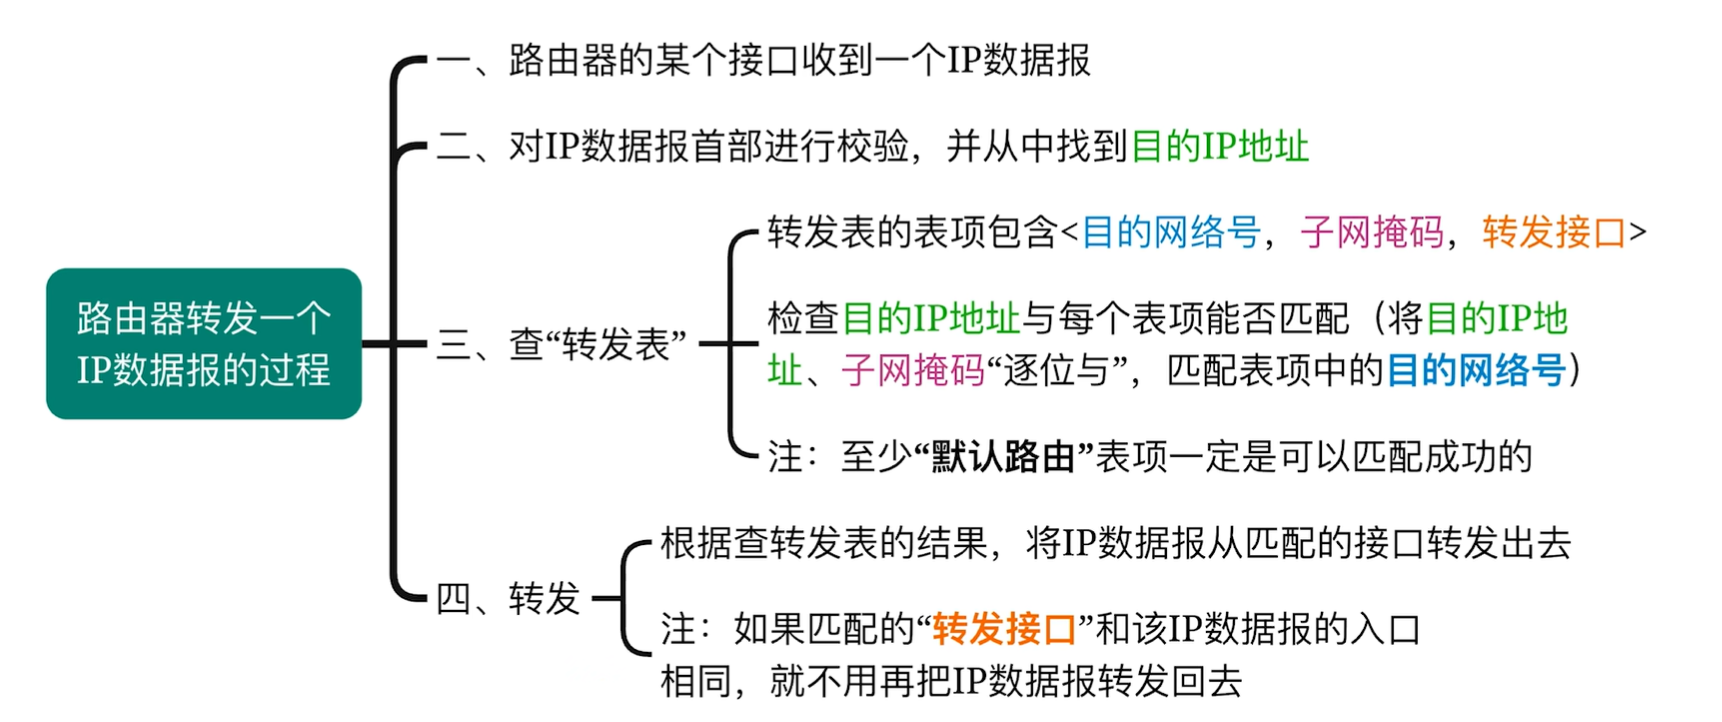
- 如果一台路由器支持子网划分技术,那么在它的转发表中,需要包含<目的网络号,子网掩码,转发接口>
- 当数据包到达时,路由器把数据包的目标地址与每个子网掩码进行相与操作,看是否对应于某个前缀,确定输出接口
默认子网掩码: 如果一个传统网络(A/B/C类)内部没有进行子网划分,那么可将此网络的转发表设置为默认子网掩码
- A类默认255.0.0.0
- B类默认255.255.0.0
- C类默认255.255.255.0 默认路由:
- 默认转发表项设置:<目的网络号全0,子网掩码全0>
- 在路由器转发表中,如果所有表项都不匹配,那么将从默认路由转发出去
CIDR
Classless InterDomain Routing 无类域间路由
问题:
- 传统的IP地址分配方案的缺陷:IP地址资源不灵活,利用率低,有限的IP地址资源将很快耗尽
- 路由选择表暴涨
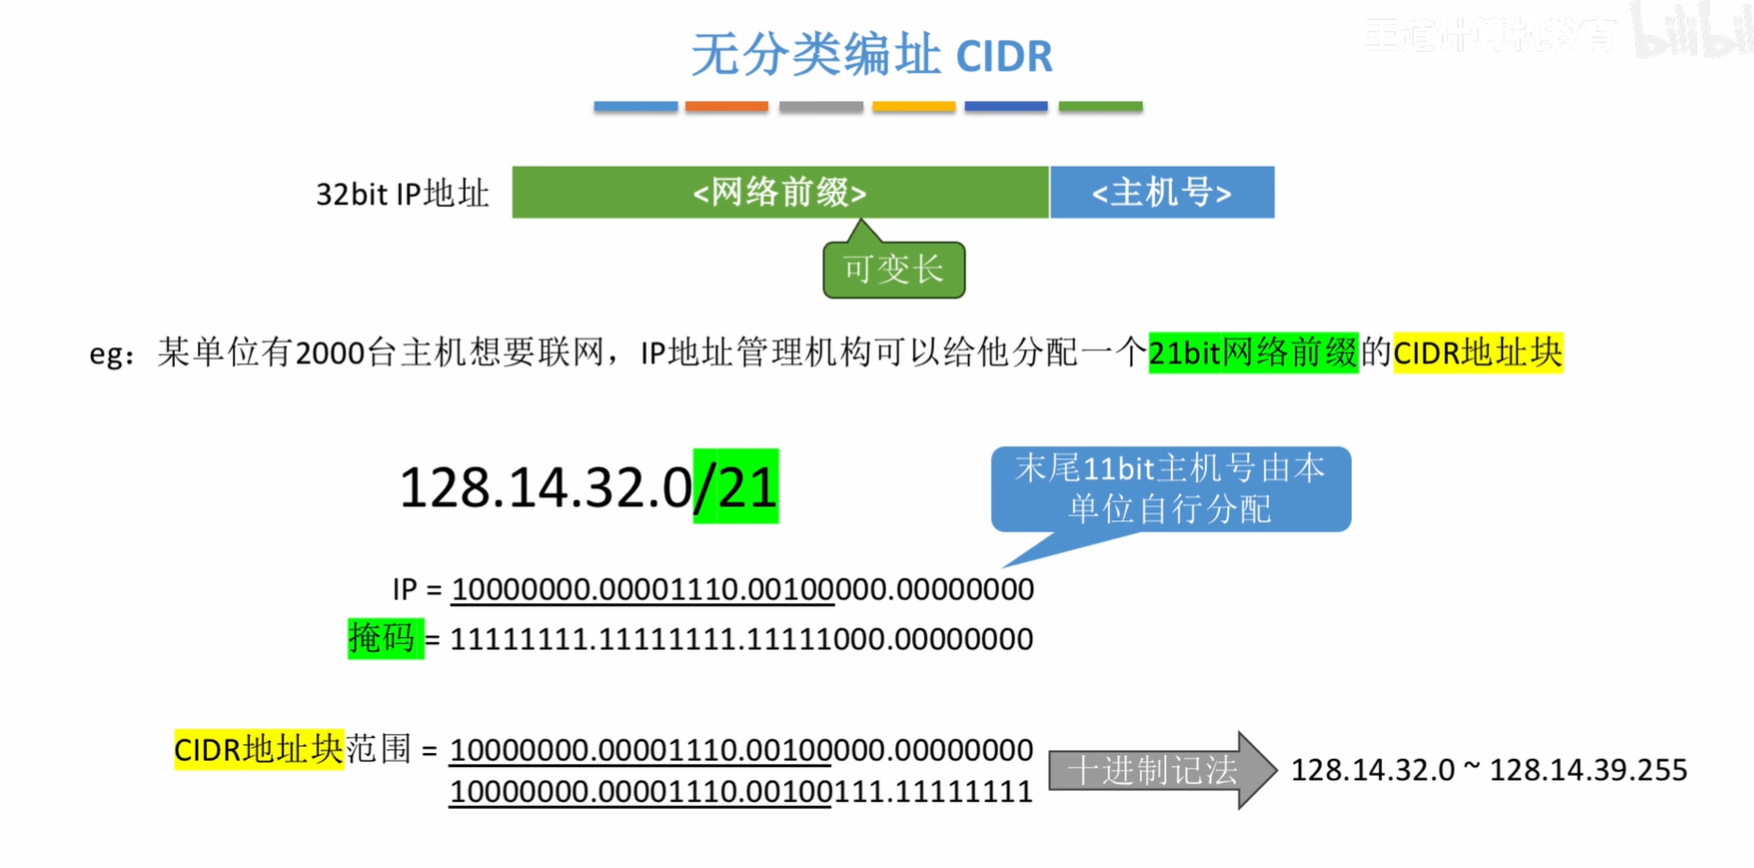 一个单位获得CIDR地址块后,可以把它划分为多个子网
- 定长子网划分
- 在一个CIDR地址块中,把主机号前 k bit抠出来作为定长子网号,这样划分出
个子网(每个子网包含的IP地址块大小相等) - 缺点:每个子网都一样大,不够灵活,IP地址利用率低,浪费有限的IP地址资源
- 在一个CIDR地址块中,把主机号前 k bit抠出来作为定长子网号,这样划分出
- 变长子网划分
- 在一个CIDR地址块中,划分子网时,子网号长度不固定(每个子网包含的IP地址块大小不同)
💡CIDR地址块的子网划分技巧,可以用类似于从根到叶构造二叉哈夫曼树的技巧
- 在一个CIDR地址块中,划分子网时,子网号长度不固定(每个子网包含的IP地址块大小不同)
- 原始CIDR地址块作为根节点(假设根节点中可以自由分配的主机号占hbit)
- 每个分支节点必须同时拥有左右孩子,左0右1
- 每个叶子节点对应一个子网,根据根节点到达叶子节点的路径来分析子网对应的IP地址块范围
- 整棵树的高度不能超过h-1(因为即便最小的子网也至少要保留2bit主机号)
例题:
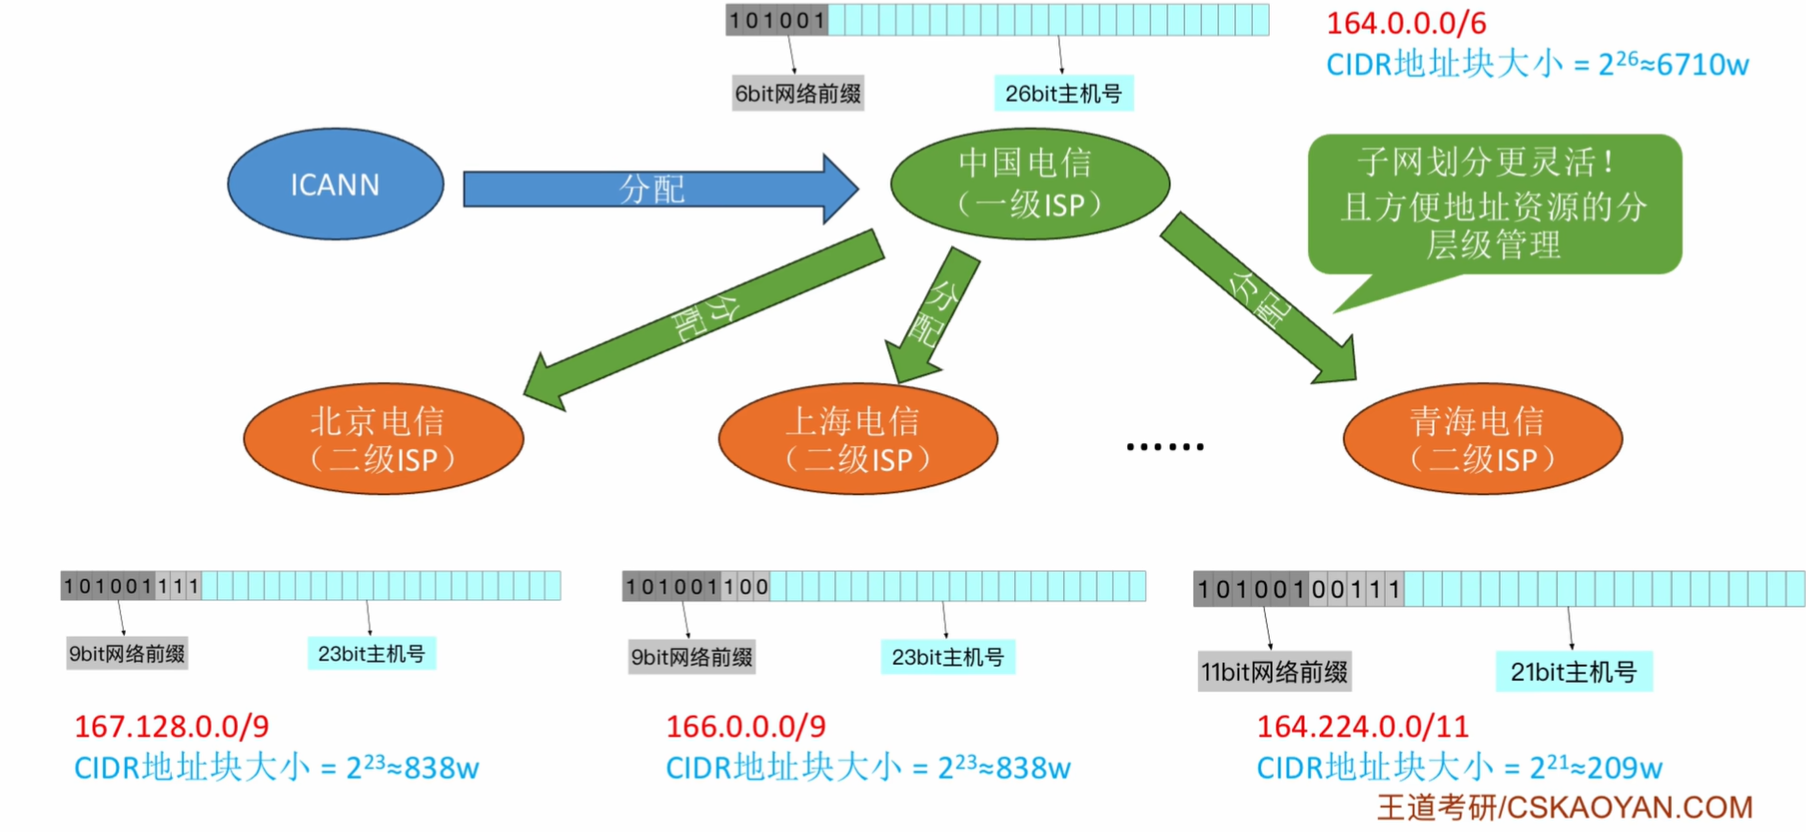
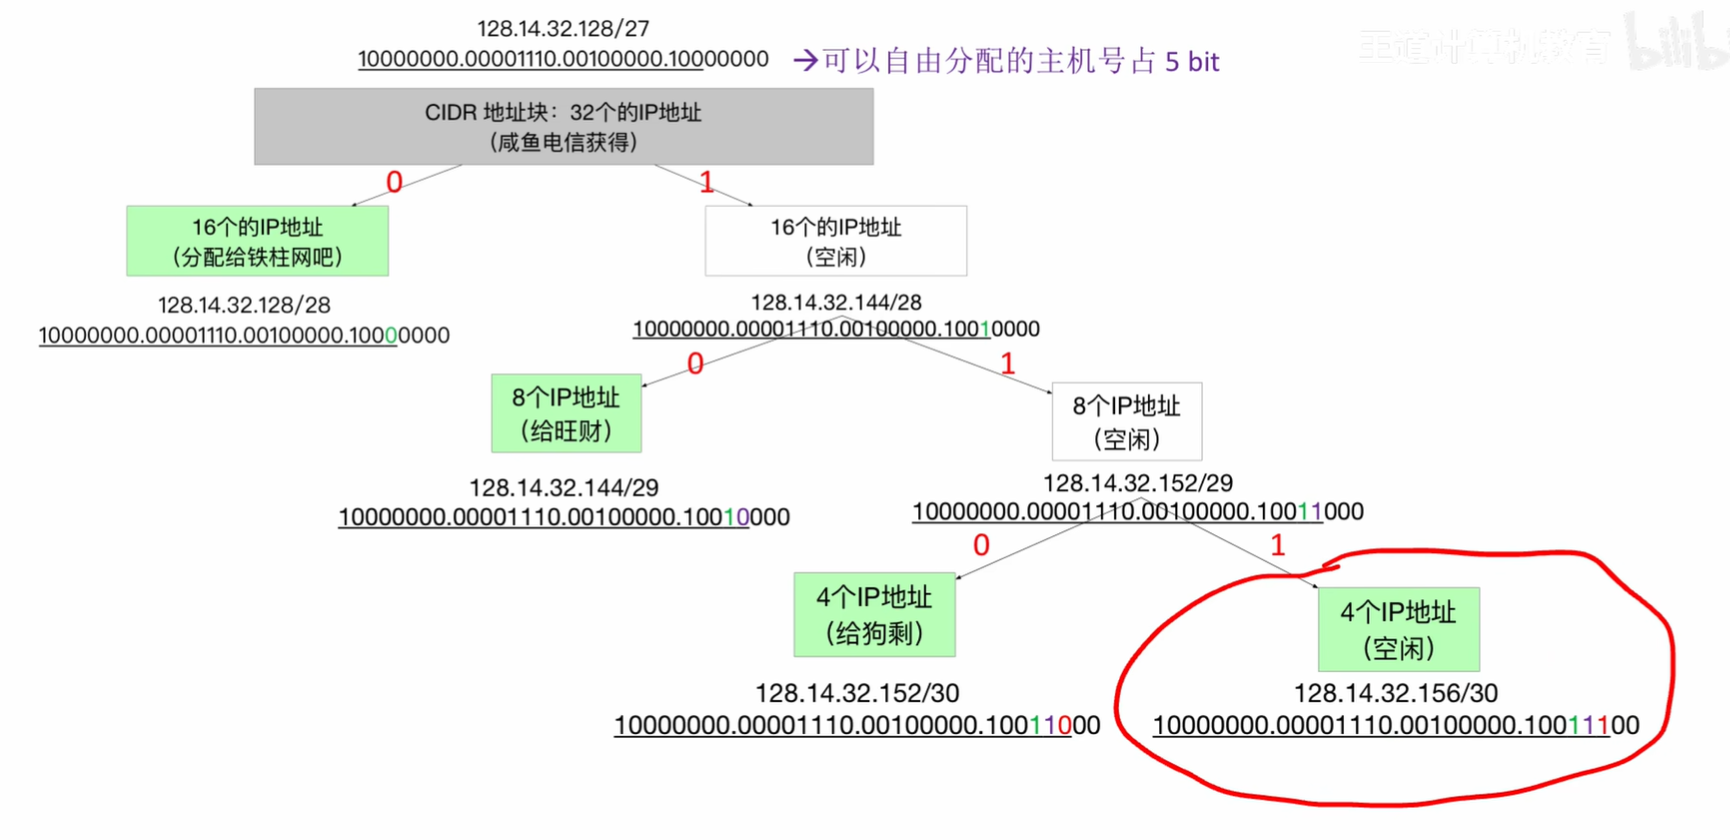
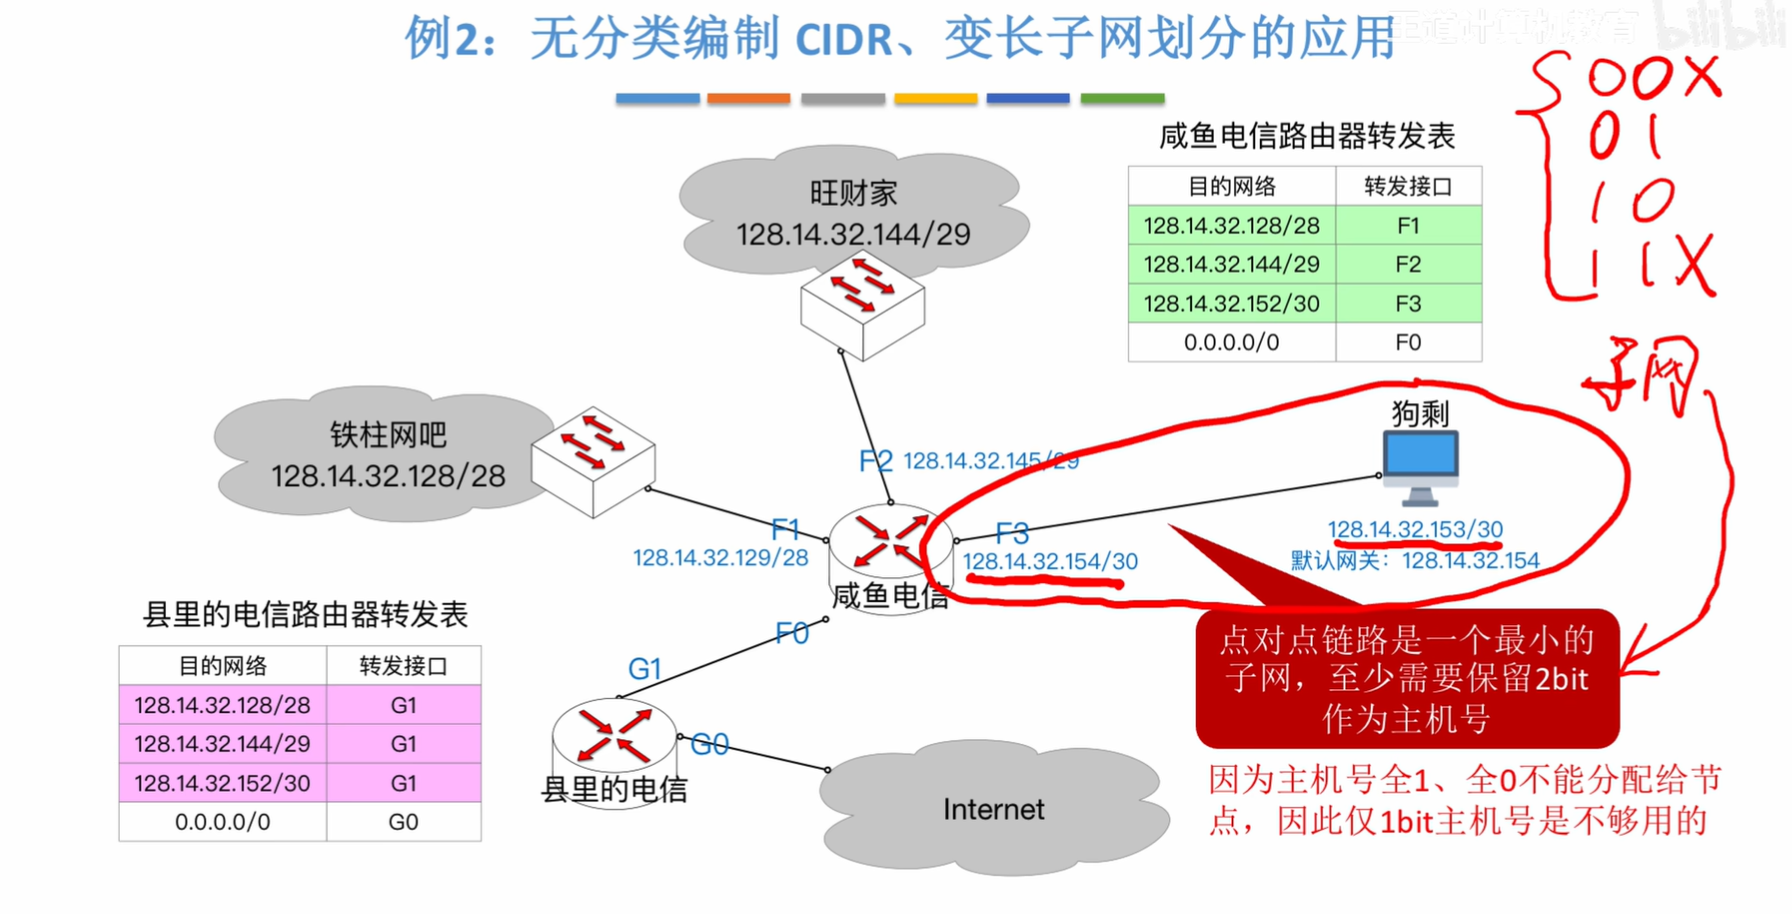 💡CIDR地址块的子网划分技巧,可以用类似于从根到叶构造二叉哈夫曼树的技巧
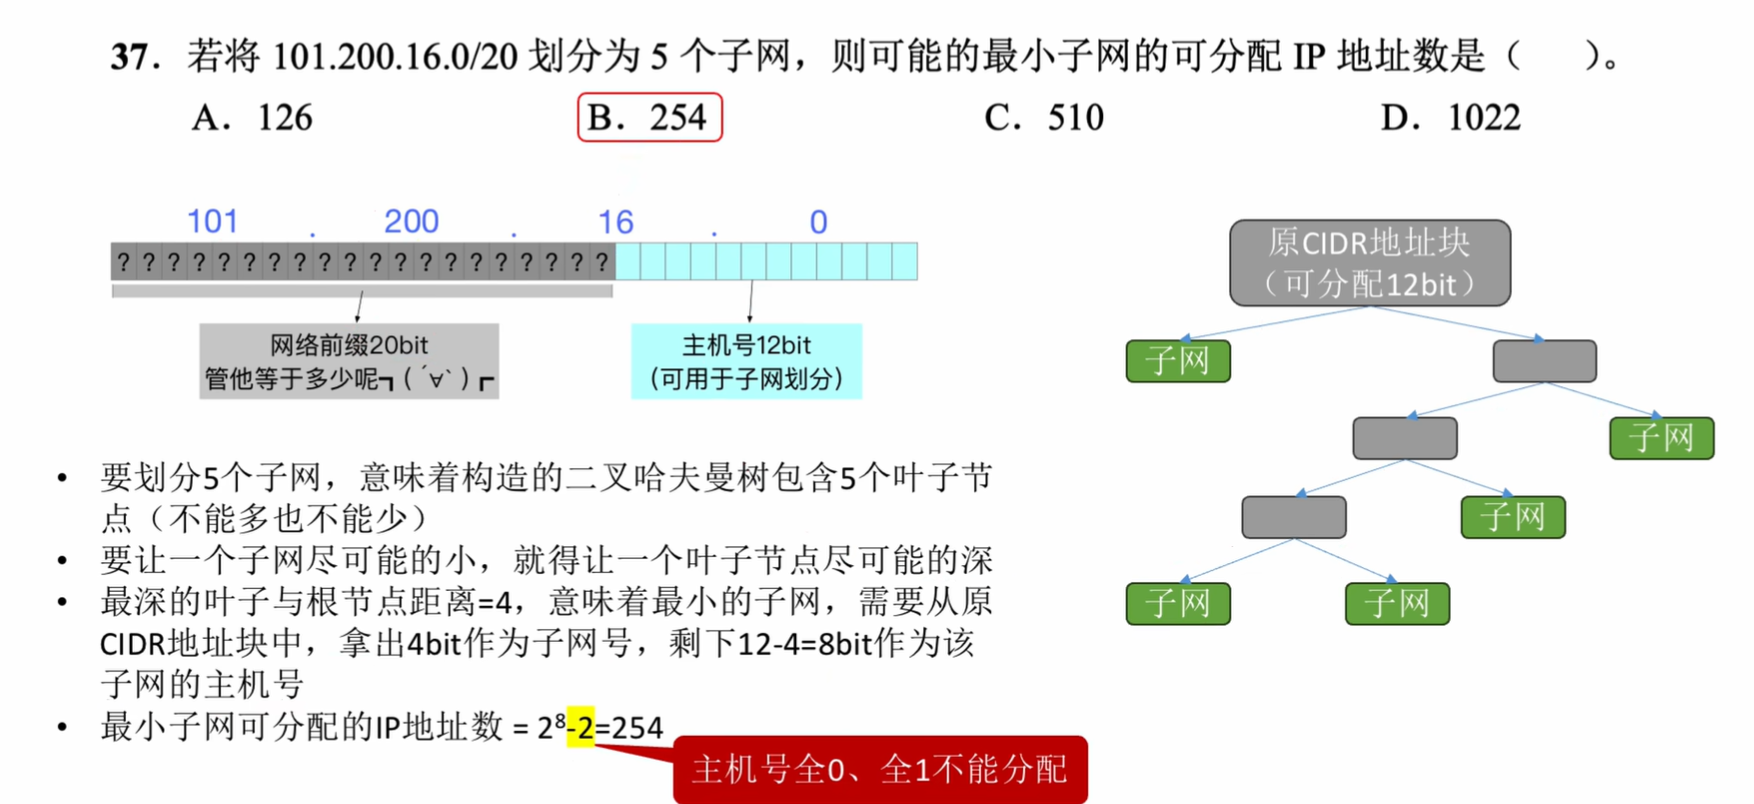
路由聚合
路由聚合:对于一个路由转发表,如果几条路由表项的转发接口相同,部分网络前缀也相同,那么可以将这几条路由表项聚合为一条,这种地址的聚合称为路由聚合,也称构成超网
好处:
- 减少路由表的大小,查询速度快,路由器的转发时延更低
- 路由聚合可能引入额外的无效地址
最长前缀匹配: 一个IP地址在转发表中可能会匹配多个表项,此时应使用最长前缀匹配(看最多有几位相同)的原则
总结: 什么是CIDR:CIDR 是一种无类编址方法,它用“IP 地址/前缀长度”表示网络,不再受 A、B、C 类地址固定划分的限制,可以更灵活地分配 IP 地址,并通过路由聚合减少路由表规模。 CIDR的工作原理:当一个数据包到达时,路由器扫描路由表以确定目的地是否在前缀的地址块内。有可能多个具有不同前缀的表项得到匹配,在这种情况下,使用具有最长前缀的表项,具体方法
- 计算每个prefix对应的子网掩码
- 每个子网掩码和数据包ip地址进行与操作对比prefix
- 多个match选择子prefix长的选项
NAT
Network Address Translation网络地址转换
基本思想:ISP为每个家庭或每个公司提供一个IP地址(或者最多分配少量的IP地址),用这个IP地址来传输Internet流量。在客户网络内部,每台计算机有唯一的IP地址(私有IP地址),该地址主要用来路由内部流量。然而当一个数据包需要离开客户网络时,发向其他ISP时,它必须执行一个地址转换,把唯一的内部IP地址转换成那个共享的公共IP地址/外网IP。这个地址转换使用了IP地址的三个范围,这些地址已经被声明为私有化,任何网络可以在内部随意地使用这些地址
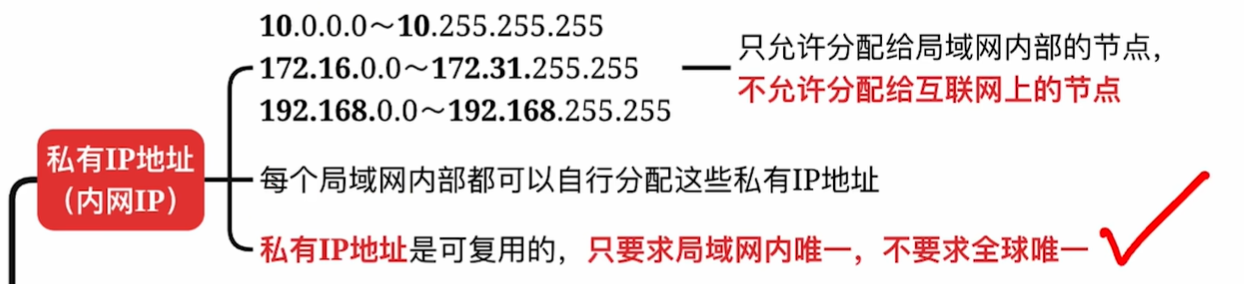
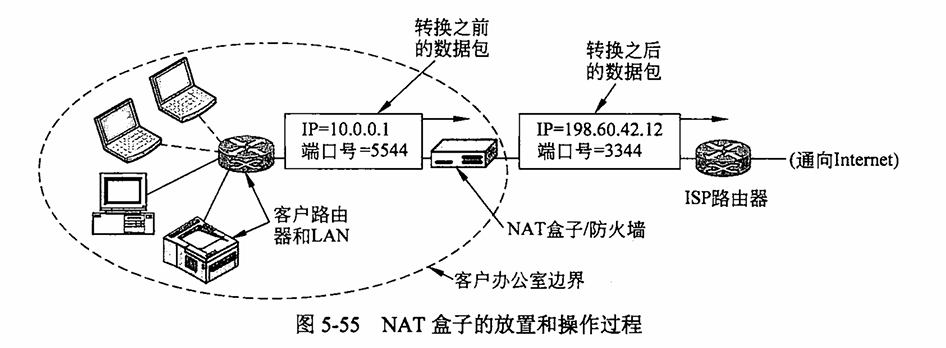
当应答数据包返回时,如何知道该用哪个地址来替代呢? 一个进程希望与另一个远程进程建立 TCP 连接时,它把自己绑定到一个本地机器未使用的 TCP 端口上。该端口称为源端口(source port),它告诉 TCP 代码凡是属于该连接的入境数据包都应该发送给该端口。这个进程还要提供一个目标端口(destination port),以指明数据包传输到远程机器上之后应该交给谁处理。
- 0~1023 之间的端口都是保留端口,用于一些知名的服务
解释:
NAT(Network Address Translation,网络地址转换) 是一种在内网和外网之间进行地址转换的技术。内部网络使用私有 IP 地址,外部网络使用公网 IP 地址。当内网主机向外网发送数据时,NAT 路由器会将数据包的源私有 IP 地址和源端口号转换为公网 IP 地址和新的端口号,并在 NAT 转换表中记录二者的映射关系。当外网返回数据包时,NAT 路由器根据目的公网 IP 地址和目的端口号查询映射表,找到对应的内网私有 IP 地址和端口号,然后修改数据包的目的地址和端口号,将数据包转发给对应的内网主机。这样多个内网主机就可以共享一个公网 IP 地址访问互联网。
问题:
- NAT 违反了 IP 的结构模型。
- NAT打破了端到端的连接模型,任何一个主机可在任何时间内给任何一台其他主机发送数据包
- NAT 将互联网从无连接网络变成了一个面向连接网络特有的形式
- NAT 违反了最基本的协议分层规则:第k层不应该对第k+1层在本层的有效载荷字段中放什么任何假设。分层思想是保证某一层的变化不会要求其他层也跟着改变,NAT破坏了这种独立性
- Internet上的进程并不一定必须使用TCP或者UDP
- 有些应用以规定的形式使用多个TCP/IP连接或者UDP接口
- 由于 TCP 源端口字段是 16 位的,因此最多只能将 65,536 台机器映射到一个 IP 地址上
Internet控制协议
ICMP
Internet Control Message Protocol Internet 控制消息协议
当路由器在处理一个数据包的过程中发生了意外,可通过ICMP向数据包的源端报告有关事件
ARP
Address Resolution Protocol 地址解析协议
ARP(地址解析协议):在已知目的IP地址,需要知道目的硬件地址时使用
某一层的地址只在本层有效,网络层负责寻找路径,而真正实现消息传递的是链路层,所以要实现两层地址之间的映射。
即关键在于已知源IP、源MAC和目的IP的情况下怎样获取目的MAC
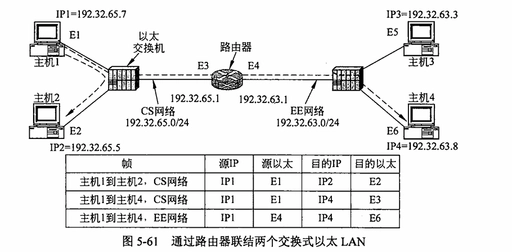
具体例子如上图所示,有两个/24的网络(左侧为CS网络,右侧为EE网络),这两个局域网通过一个IP路由器相连。以太网的每台机器和路由器上的每个接口都有一个唯一的以太网地址,E1~E6。
- (同一子网的消息传递)主机1用户给主机2用户发送数据包 ① 根据已知域名找到主机2的IP(由DNS系统返回IP地址) ② 主机 1 发送一个广播包到以太网络上请求拥有 IP 地址192.32.6.5.5 的主机。该广播包将会到达 cs 网络上的每一台主机,并且每台主机都会检查自己的IP地址。只有主机2会用自己的以太网地址 (E2)作为应答。通过这种方式,主机1 得知IP 地址 192.32.65.5 是一台拥有以太网地址为E2的主机。
请求和获得应答两个过程所使用的协议称为地址解析协议 (ARP, Address Resolution Protocol)
- (不同子网消息的传递)主机 1 给 EE 网络上的主机 4发送数据包 (1)主机 1 发现目标 IP 地址不在 cs 网络。同时它知道应该把所有这些网络外的流量发给路由器,该路由器称为默认网关(Defaultgateway)
按照惯例,默认网关具有网络上的最低地址(198.31.65.1 )
为了给路由器发送帧,主机 1 必须知道该路由器在cs 网络上的接口地址。因此,主机1 发送一个ARP广播报文,请求198.31.65.1 对应的以太网地址,从该广播报文的应答报文它获知所需的以太网地址为E3:然后用该地址给路由器发送帧。 如果路由器不知道主机4的以太网地址,它可以再次使用ARP。
(2)主机1不知道主机4在另一个子网上,仍然可以从主机1 发送一个数据包给主机4。解决办法是让cs 网络上的路由器回答针对主机4的ARP请求,并且以E3 作为响应。然后,路由器将收到发给192.32.63.8 的帧,并将该帧转发到 EE 网络。这个解决方案称为ARP代理(proxyARP)
在以太网上广播时,以太网帧的目的地址全为1,即FF-FF-FF-FF-FF-FF-FF
RARP:由已知硬件地址查找IP地址的过程叫做反向地址解析( Reverse Address Resolution )
- ARP、RARP都是广播协议——网络上的每一台机器都能收到请求
- 每一台机器都检查请求的IP或Ethernet Address,符合要求的主机回答请求
DHCP
Dynamic Host Configuration Protocol 动态主机配置协议
动态主机配置协议(DHCP)是用于互联网协议(IP)网络上的主机的网络配置协议
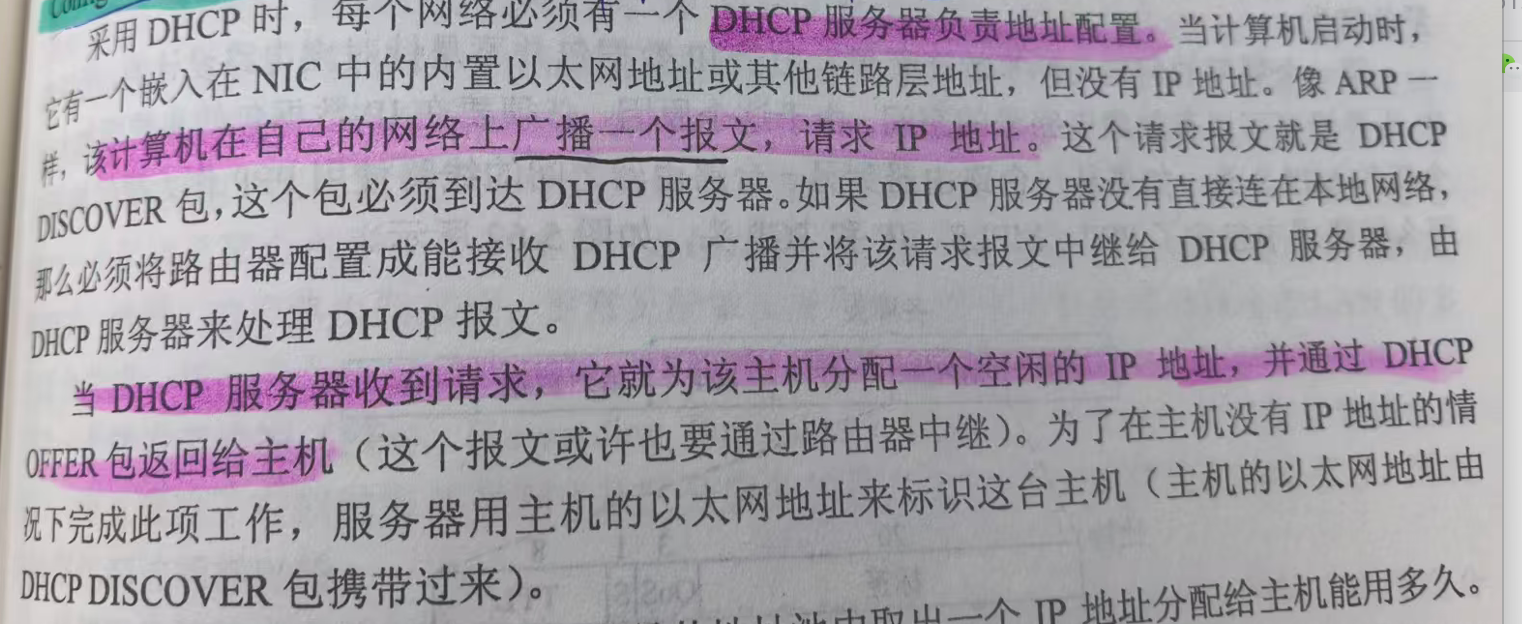 DHCP消除了网络管理员的手动任务
OSPF
Interior Routing Protocol 内部网关路由协议
OSPF:开放的最短路径优先协议。是一种常用的内部网关协议,属于链路状态路由协议的一种 OSPF 是链路状态路由协议的一种,它会把一个网络内部的路由器和 LAN 抽象成一张带权有向图。路由器、LAN 都可以作为图中的节点,链路作为边,边上的数字表示代价。对于广播型 LAN,OSPF 会把它建模成一个特殊的中间节点,与连接到该 LAN 的路由器相连。然后 OSPF 在这张图上使用最短路径算法,计算到各个网络的最优路由
BGP
The Exterior Gateway Routing Protocol 边界网关协议
BGP:边界网关协议。用于连接自治域。是一种改进了的距离矢量路由协议,保存完整的路由信息
BGP 是自治系统之间的路由协议。它在多个相互连接的网络之间计算路由,但它不像 OSPF 那样主要追求最短路径,而是更重视策略约束。BGP 选路时会考虑商业关系、费用、性能、安全、政治因素以及网络运营者的管理策略。因此,BGP 的核心不是简单地找“最近的路”,而是找一条“符合策略、允许使用、成本和性能合适”的路。